Arquitectura del sistema
Arquitectura física
Las herramientas del proyecto OMI pueden ser dispuestas sobre diferente arquitectura física. Por un lado se puede hacer uso del intérprete como una herramienta de un sistema operativo GNU/Linux, siguiendo así una arquitectura de escritorio. Por otro se puede usar el sistema en como una arquitectura cliente/servidor.
Escritorio
El cliente OMI puede ser utilizado en una arquitectura de escritorio, funcionando como un comando del sistema. Para ello solo se precisa de un PC con un sistema operativo GNU/Linux.
Cliente/servidor
El intérprete OMI puede ser usado en una arquitectura cliente/servidor, en la que hace de servidor. El servidor OMI espera una petición para un proceso de interpretación. Esta petición contendrá el código fuente que se desea interpretar.El servidor OMI procesa un código fuente para su interpretación devolviendo una estructura de datos en formato JSON que representa el árbol de nodos resultado del análisis léxico y sintáctico. Luego espera peticiones para resolver cada paso dentro del proceso de interpretación y devolver una estructura de datos en el mismo formato que representa qué ha ocurrido mediante el estado actual.
El sistema servidor es independiente del cliente en el sentido de que pueden usarse distintos clientes para el mismo servicio. El proyecto OMI presenta un cliente web llamado runTree que funciona en cualquier navegador moderno, no obstante se puede usar otra tecnología como cliente.
Para ejecutar el sistema en una arquitectura cliente servidor se precisa de un equipo que tenga conexión a internet con un navegador web que hará de cliente. Por otro lado se necesita de un equipo servidor que presente una alta disponibilidad. Este equipo dispondrá de uns sitema GNU/Linux sobre el que se ejecutará el intérprete y un servidor web Apache que servirá de plataforma para dar el servicio web.
Arquitectura lógica
En esta sección se presenta la arquitectura del sistema. Se presentan dos niveles de organización la parte frontal (front-end) y la parte interna o motor (back-end).La parte frontal se encarga de analizar y procesar la entrada del usuario. Una vez tratada la entrada, se pasa la ejecución a las estructuras que conforman el motor del sistema. Estas llevarán a cabo una serie de tareas que puden producir un resultado que será enviado al frontal. La parte frontal mostrará los datos como salida del programa en un formato establecido.
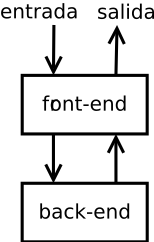
Aunque bien se podría haber especificado otra capa correspondiente a la gestión de datos llevada a cabo por las tablas de símbolos, esta se ha incluido en la parte del motor. Los datos que las tablas de símbolos tratan no mantienen persistencia, están muy ligados al proceso interno de interpretación y no representan los datos correspondientes al modelo de datos, sino que sirve para referenciar componentes de la capa del motor de la aplicación.
Frontal (front-end)
El frontal del sistema se compone de un analizador léxico y un analizador sintáctico. Aunque es posible especificar reglas léxicas mediante reglas gramaticales, se ha separado el estos dos componentes por los siguientes motivos:
- La reglas lexicográficas suelen ser muy simples y para su descripción no se precisa de una notación tan compleja como las gramaticales.
- Las expresiones regulares son más concisas y fáciles de entender que las gramáticas
- A partir de expresiones regulares se puede describir analizadores léxicos eficientes.
- Se modulariza el proceso en dos componentes con objetivos bien definidos.
Además del analizador léxico y sintáctico el front-end contiene estructuras funcionales correspondientes a la toma de datos de entradas y a la impresión de la salida.
Analizador léxico
El analizador léxico implementa una gramática de tipo 3 en la jerarquía de Chomsky, estas se corresponden con las gramáticas regulares.
Las gramáticas regulares, también llamadas gramáticas finitas, se pueden describir mediante expresiones regulares.
Cada expresión regular denota un lenguaje  . Una expresión regular se construye a partir de otras expresiones
más simples, utilizando un conjunto definidos de reglas. Estas reglas indican la manera de conseguir el conjunto
combinando de varias formas los lenguajes denotados por las subexpresiones de
 . Las expresiones regulares
se pueden definir de una forma recursiva como sigue:
 es una expresión regular que denota el lenguaje que unicamente contiene la cadena vacía.
- Si
 fuese un símbolo del alfabeto, entonces es una expresión regular que denota el lenguaje formado
por la cadena .
- Si y
 son dos expresiones regulares que denotan los lenguajes y
 respectivamente entonces:
-
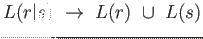
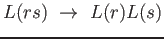
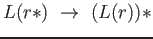
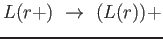
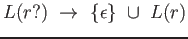
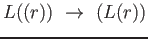
Las gramáticas regulares pueden ser implementadas mediante un autómata finito. Un autómata finito se define formalmente como sigue:
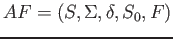
De forma que:
 es un conjunto de estados.
 es el conjunto de símbolos que conforman el alfabeto.
 es una función de transición tal que
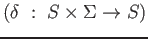 . Donde para cada estado y según
cada carácter de entrada del alfabeto le hace corresponder un nuevo estado.
 es el estado inicial.
 es un conjunto de estado finales.
El analizador léxico se corresponde con un autómata finito donde, al alcanzarse un estado final, se produce la generación de un token. Un token es un elemento léxico con cierto valor para el lenguaje. Normalmente se corresponde con una cadena de caracteres que se puede corresponder con una palabra reservada, un identificador, un número... Un token puede contener un valor. Los token son utilizados por el analizador sintáctico para llevar a cabo el procesamiento del código fuente.
Las reglas lexicográficas a partir de las cuales se construye el analizador léxico son descritas junto la gramática, haciendo uso de expresiones regulares y diagramas sintácticos.
Analizador sintáctico
El analizador sintáctico implementa una gramática de tipo 2 en la jerarquía de Chomsky, esta se corresponden con las gramáticas independientes del contexto. Una gramática de este tipo, como su propio nombre indica, no depende del contexto para su resolución, lo que origina que los recursos que permiten analizarlas sean relativamente eficientes y simples. Una gramática de este tipo pueden ser analizadas mediante algoritmos con un orden donde
 es el tamaño de la entrada. No obstante existen
un subconjuntos de este tipo de gramáticas como las
 y
 que pueden ser analizados en tiempo
 . Estos últimos son los
comúnmente utilizados en los lenguajes de programación.
En el análisis sintáctico se pueden utilizar métodos descendentes o ascendentes, en función de cómo se genera el árbol sintáctico.
Los métodos de análisis descendentes tienen como objetivo construir el árbol de derivación desde la raíz hacia las hojas. Normalmente se
utilizan analizadores del tipo  dado que la entrada es tratada desde la izquierda y las reglas de producción también desde la izquierda.
Estos tipos de analizadores tienen el problema de la incertidumbre, debido a que dado un símbolo no terminal debe determinar qué regla de derivación aplicar.
La incertidumbre puede ser reducida mediante métodos como el retroceso o la predicción.
Los métodos de análisis de ascendentes pretenden construir el árbol de derivación o de sintáxis desde las hojas hacia la raíz. Para este tipo normalmente se utiliza
analizadores del tipo  dado que la entrada es tratada desde la izquierda, mientras que las reglas de producción son tratadas desde la derecha. Este tipo de
analizadores reducen la incertidumbre dado que se parte de una una regla de derivación para obtener el símbolo no terminal que se corresponde a la misma.
Para el lenguaje tratado en este proyecto se tomará un analizador sintáctico ascendente , dado que es uno de los más utilizados, son eficientes y
existen herramientas que permiten su generación automática a partir de la descripción de la gramática.
Las gramáticas libres de contexto son analizadas mediante un autómata de pila. La configuración en un momento dado del analizador se corresponde con el contendido de la pila y el resto de la entrada que aún está por analizar. La entrada estará constituida por tokens obtenidos por el analizador léxicos, teóricamente estos serán almacenados en una estructura de buffer, pero en la práctica estos son generados bajo demanda por el analizador léxico. En la pila se irá almacenando una serie de estados en función del procesamiento realizado sobre la cadena de entrada. El autómata puede llevar a cabo dos operaciones:
- Desplazar:
- Consiste en sacar del buffer de entrada un símbolo terminal e introducir el estado correspondiente en la pila.
- Reducir:
- Consiste en reducir estados del tope de la pila al estado correspondiente, según las reglas de producción.
El análisis finaliza cuando se produce un estado de aceptación o de error.
En la práctica este tipo de analizador sintáctico se implementa mediante un programa monitor que encierra la lógica descrita, un buffer de entrada en el que se almacenan los tokens, una pila que almacena los estados producidos, y dos tablas. La primera tabla guardará las acciones y determina, para el estado actual y el primer símbolo del buffer, la acción a realizar (desplazar o reducir). La otra tabla, la tabla de saltos, es utilizada tras llevarse a cabo una de reducción, y determina a partir del estado en el tope de la pila tras la reducción y la regla que se utilizó para la misma, el siguiente estado a introducir en la pila.
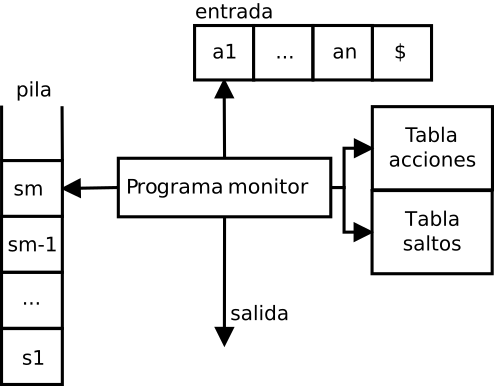
Por cada reducción que se lleve a cabo se creará un nodo del árbol sintáctico. De esta forma el árbol es creado desde las hojas hacia la raíz. Cada nodo encierra un significado semántico que será llevado a cabo cuando se ejecuten. Estos nodos constituyen a su vez el motor, o back-end, del sistema.
Mecanismos de entrada/salida
En el nivel de front-end también se dan los diferentes componentes para capturar la entrada del usuario, así como para facilitar la salida que produce en sistema.La entrada más común supondrá código fuente que será interpretado y ejecutado. Este se podrá dar de varias formas:
- Mediante la entrada estándar del sistema.
- Contenido en fichero.
- Mediante un intérprete de línea.
Es posible que se den datos de entrada que no sean código fuente, como por ejemplo, una extensión que debe ser cargada, la opción de mostrar ayuda ...
Por otro lado los datos de salida que produce el programa normalmente serán volcados en la salida estándar sistema en forma de cadenas de caracteres. Esta será el resultado visual de la interpretación del código fuente, aunque es posible que un determinado código fuente no produzca salida de este tipo.
El programa debe ser capaz de procesar los errores y mostrarlos por la salida de errores del sistema. Para ello debe controlar las líneas y ficheros procesados en cada momento. Los errores pueden ser de diferente tipos:
- Errores léxicos.
- Errores sintácticos.
- Errores semánticos.
Además los errores pueden presentar diferente grado:
- Avisos:
- Informan de que algún recurso del lenguaje no se utiliza de la forma habitual, y aunque no se produce un error como tal, puede suponer un error de codificación.
- Normales:
- No finalizan la ejecución del código fuente pero provocan que la sentencia en la que sucede no se pueda ejecutar.
- Críticos:
- Finalizan la ejecución del código fuente.
Motor (back-end)
El motor del sistema lo conforman los nodos creados mediante el análisis sintáctico. Estos nodos se denominan nodos ejecutables, dado que su procesamiento conlleva la realización operacional de la semántica que encierran. Los nodos ejecutables se categorizan según el tipo de operaciones que conlleva su ejecución, así existen nodos aritméticos, lógicos, de control de flujo, de definiciones...El sistema presenta una jerarquía de nodos ejecutables que establece la naturaleza de los mismos, dotándolos de características de una forma general y que serán concretadas en los niveles más bajos de la jerarquía. Se presenta de esta forma, nodos ejecutable genéricos como expresiones, referencias, imprimibles....
El procesamiento de un nodo ejecutable, que fue creado a partir del análisis sintáctico, puede originar la creación de otros nodos ejecutables, a estos últimos se les denominará nodos ejecutables dinámicos. Un nodo dinámico es creado y referenciado por una estructura de datos denominada tabla de símbolos. Esta estructura también es considerada un componente del motor del sistema.
Los nodos ejecutables presentan dos niveles de procesamiento semántico: la inicialización y la ejecución. Además también se ha de controlar cómo estos son creados y eliminados de forma dinámica en la tabla de símbolos.
Inicialización
Todo nodo ejecutable se inicializa a partir de otros nodos ejecutable sobre los que operará. Normalmente estos nodos se corresponderán con los hijos del nodo en cuestión en el árbol sintáctico.La inicialización de un nodo ejecutable se lleva a cabo durante la creación del árbol sintáctico, por tanto los nodos se inicializan de una forma ascendente, es decir, antes los nodos hijos que los padre.
Durante la inicialización se lleva a cabo algunas comprobaciones de tipos, asignaciones y otras operaciones. No obstante, todo proceso que se lleve a cabo durante la inicialización debe ser independiente de la ejecución. Se ha de tener en cuenta que un nodo ejecutable sólo se inicializa una vez, y sin embargo se puede ejecutar varias veces, siendo esta última dependiente del estado en un momento dado. Se puede decir pues que la inicialización tiene un carácter estático.
Ejecución
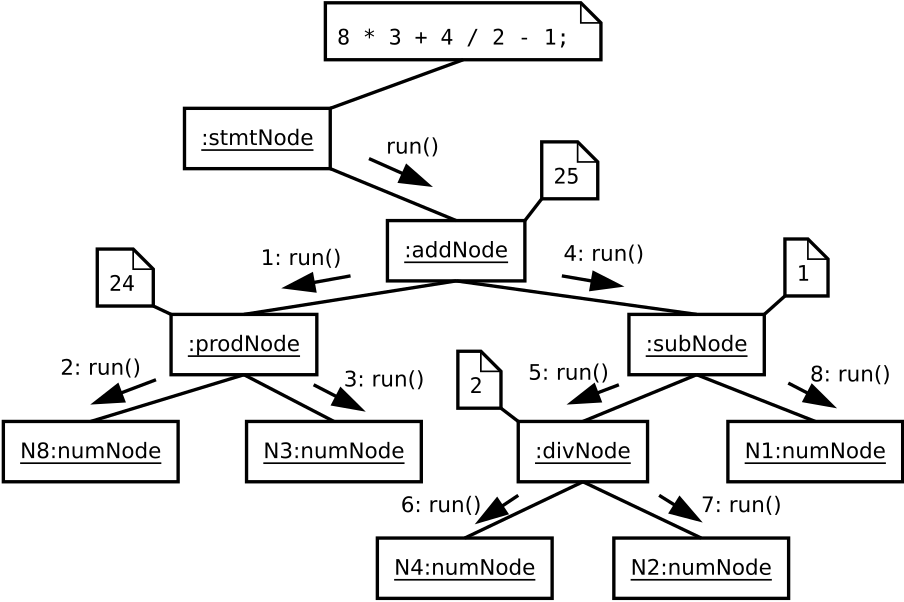
Una vez generado el árbol sintáctico, lo que conlleva la inicialización de los nodos ejecutables que lo componen, se procede a la ejecución del mismo. La ejecución comienza desde el nodo raíz hacia las hojas, se hace pues un recorrido del árbol en profundidad.La ejecución de un nodo es iniciada normalmente desde su nodo padre, y generalmente conlleva la ejecución de sus nodos hijos antes de proceder a su propia ejecución. Así por ejemplo la ejecución de un nodo suma conllevará el cálculo del lado izquierdo de la expresión, lo que se corresponde con la ejecución uno de sus nodos hijo, luego se calculará el lado derecho, correspondiente a la ejecución del otro nodo hijo, para, una vez ejecutados sus hijos (los operandos), proceder al cálculo de la suma, lo que se corresponde con su propia ejecución.
Durante la ejecución de un nodo ejecutable lo normal es que primero se resuelvan los nodos referencias, aquellos que se corresponden con nodos dinámicos de tipos no definidos. Estos nodos referencian a otros nodos creados dinámicamente en la interpretación y que se encuentran accesibles desde la tabla de símbolos. Algunos nodos referencias, también denominados nodos de expresiones no definidas, son los correspondientes a: variables, funciones u clases de objetos. Una vez se ha obtenido el nodo al que estos referencian, se procede con la ejecución como si los nodos obtenidos fueran los hijos del nodo en proceso.
Aunque la ejecución del árbol se hace inicialmente con un recorrido en profundidad existen nodos que rompen esta secuencia, haciendo que la ejecución pase a nodos específicos o repitiendo la ejecución de varios de sus hijos. Cabe decir que una vez se salte la secuencia de ejecución el recorrido seguirá siendo en profundidad. Estos nodos se corresponden con sentencias de control de flujo, llamadas a funciones, etc.
El resultado de ejecutar un nodo no tiene por que ser estático, dependiendo en gran medida del contexto, es decir, del estado de la tabla de símbolos. Se puede decir pues que la ejecución de un nodo tiene un carácter dinámico dependiente de la tabla de símbolos.
Tabla de símbolos
La tabla de símbolos es una estructura de datos que almacena referencias a nodos creados dinámicamente en el proceso de interpretación. Estos nodos serán creados en la ejecución del árbol de sintáctico y serán accedidos desde la ejecución de determinados nodos en la resolución de referencias.Las tablas de símbolos se componen de pares donde el primer elemento es un identificador que nomina al símbolo y el segundo elemento es una referencia al nodo ejecutable.
Aunque en una tabla de símbolos es posible guardar referencias a cualquier nodo se mantiene diferentes tipos tablas de símbolos según la naturaleza de los nodos a los que se referencian. Esto hace posible que se puedan repetir identificadores para distintos tipos de nodos como variables, funciones o clases.
Dos identificadores que pueden estar en la misma tabla de símbolos o distintas, pueden referenciar al mismo nodo. El propio nodo debe ser capaz de guardar cuantas referencias al mismo tiene. Esto se hace por criterios de optimización, para la reutilización de datos y para realizar una eliminación del nodo de una forma segura cuando sea necesario.
Las tablas de símbolos pueden quedar organizadas en niveles, aunque únicamente un nivel, el actual en un momento dado, es el que se utilizará para la resolución de referencias. Esto hace posible definir diferentes ámbito para el acceso a determinados símbolos. Los niveles quedan dispuestos en una estructura de pila, de forma que el nivel actual es la cima de la pila. Una vez un nivel es eliminado de la pila se eliminan todas las referencias del mismo y el nivel anterior queda en la cima y por tanto es considerado el nivel actual.
Existen nodos que presentan sus propias tablas de símbolos, esto hace que muchas definiciones sean internas al mismo. Por ejemplo las clases de objetos mantienen sus propias tablas de símbolos para referencias los métodos y atributos, y los arrays presentan una tabla de símbolos para guardar las claves y sus valores. Es común que en la ejecución de uno de estos nodos se sustituya la tabla de símbolos en uso por la del nodo en cuestión.
La tabla de símbolo es una estructura de datos que forma parte del motor de la aplicación dado que gestiona y almacena datos presentes en este nivel.
Eliminación de referencias
Los nodos creados de forma dinámica por el proceso de interpretación deben ser eliminados cuando ya no se precisen de ellos. Por ejemplo cuando se produce una asignación destructiva. Como los nodos creados de forma dinámica son reutilizados y pueden ser referenciados por más de un símbolo se ha de controlar que no exista ninguna referencia al mismo antes de proceder a su eliminación. Así cada nodo guarda el número de referencias al mismo.Los nodos correspondientes al árbol sintáctico nunca serán eliminados durante la ejecución y no será hasta la finalización del programa hasta que se proceda a la liberación de los recursos que consumen.
runTree
runTree es un sistema que hace de cliente del intérprete OMI, cuando este funciona como servidor. Se encarga de llevar a cabo peticiones para navegar por el proceso de interpretación de un código fuente dado.El cliente runTree presenta una arquitectura interna en dos capas al igual que el intérprete. El backend de este se comunica con el forntend del intérprete cuando funciona de servidor
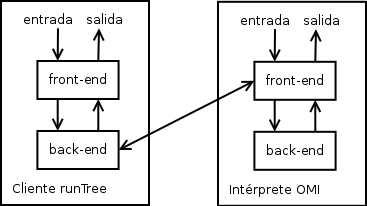
El frontend del cliente runTree lo componen elementos relacionados con la interfaz del usuario. Captura eventos de esta y lo envía al backend para su procesamiento, a su vez representa los datos que recibe del backend.
El backend del cliente runTree lo componen elementos que guardan el estado interno del proceso de interpretación. Normalmente estos elementos son inicializados mediante datos que recibe del servidor como fruto de una petición.
Diseño de la gramática
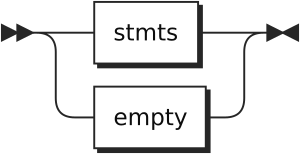
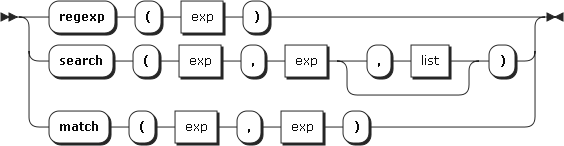
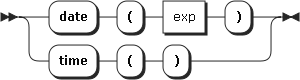
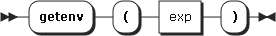
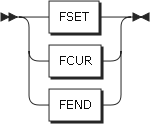
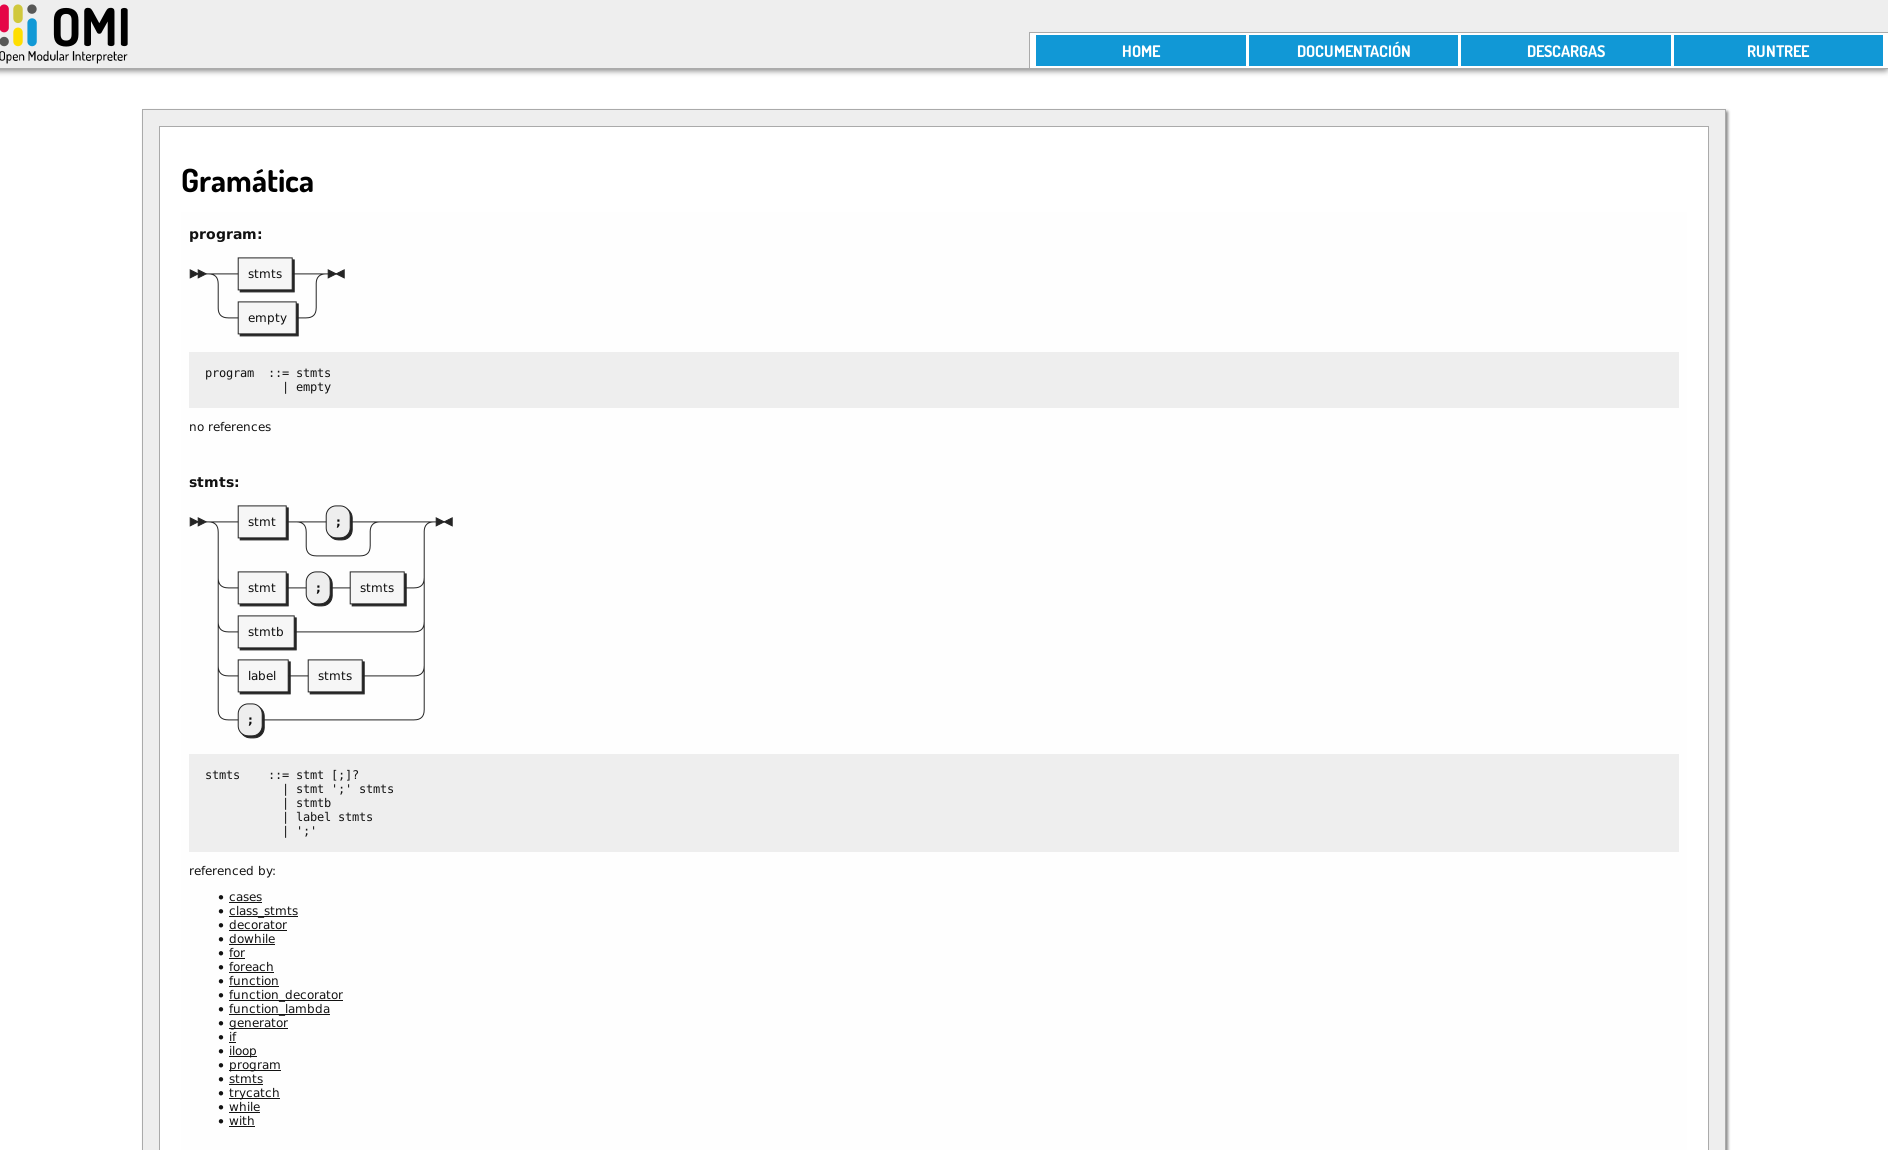
En esta sección se presenta la gramática del lenguaje, para ello se procede a una descripción de las reglas gramaticales mediante el lenguaje EBNF (Extended Backus–Naur Form) usado para expresar gramáticas libres de contexto. Además cada regla se acompaña de un diagrama sintáctico o diagrama de carril.
Una gramática  se define formalmente como sigue:
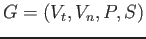
De forma que:

- es un conjunto finito de símbolos no terminales

- es un conjunto finito de símbolos terminales

- es un conjunto finito de reglas de producción
-

- es el símbolo inicial
Las reglas de producción de una grmática libre de contexto tiene la forma siguiente forma:
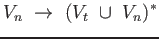
La gramática libre de contexto abordada tiene como símbolo inicial
el no terminal  . Se comienza pues describiendo las reglas de producción
relicionadas con este símbolo, siguiendo con las reglas de producción derivadas
de esta.
Las reglas de producción se organizan en niveles como sigue:
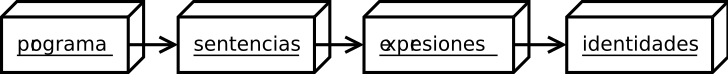
Estos niveles son dados a partir del nivel de abstracción del significado semántico que encierran las reglas de producción contenidas en los mismos.
Las reglas de producción correspondientes al nivel de programa son las más genéricas y se valen de las de la siguiente nivel para su definición. Estas definen el programa como una secuencia de sentencias. La gramática descrita contempla el programa vacío, es decir, el programa que no contiene ninguna sentencia.
Las reglas de producción del nivel de sentencia se definen a partir de expresiones o de otras sentencias. Una sentencia contiene un significado semántico operativo de valor para el programa. Cabe decir que una expresión por si sola puede constituir una sentencia. La gramática expuesta describe la sentencia vacía, esta es una sentencia que no tienen ningún significado semántico.
Las expresiones son la unidad mínima con significado semántico atribuido por el lenguaje. La mayoría de expresiones se definen a partir de identidades, sin embargo algunos tipos de expresiones, como las funciones, pueden formarse a partir de reglas de más alto nivel de abstracción semantica. Por otro lado las reglas de producción correspondiente a las expresiones están organizadas en niveles según la prioridad atribuida en su resolución.
Las identidades son reglas de producción atómicas, componiéndose únicamente de símblos no terminales. Tienen un significado semántico asociado de forma directa. Normalmente este valor viene dado por el análisis léxico.
Programa
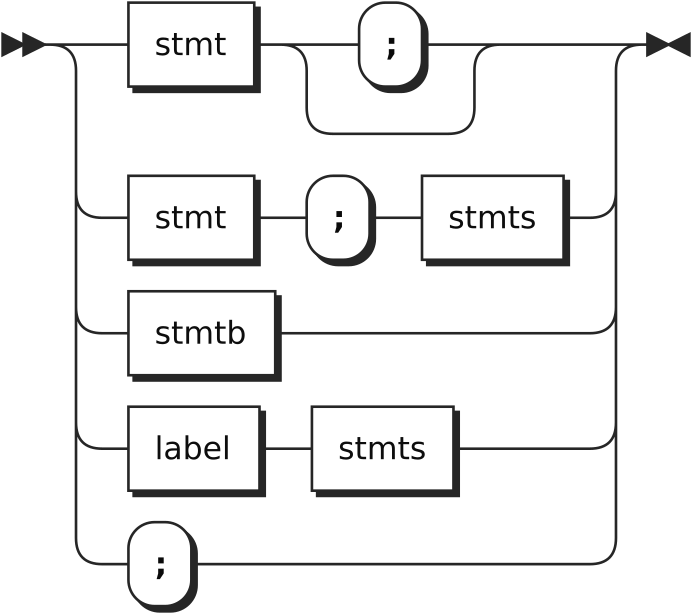
program  ::=  stmts
            | empty
Sentencias
Secuecia de sentencias
stmts    ::=   stmt ";" stmts
            |  stmt ";"?
            |  stmtb
            |  label stmts
            |  ";"
Sentencia de bloque
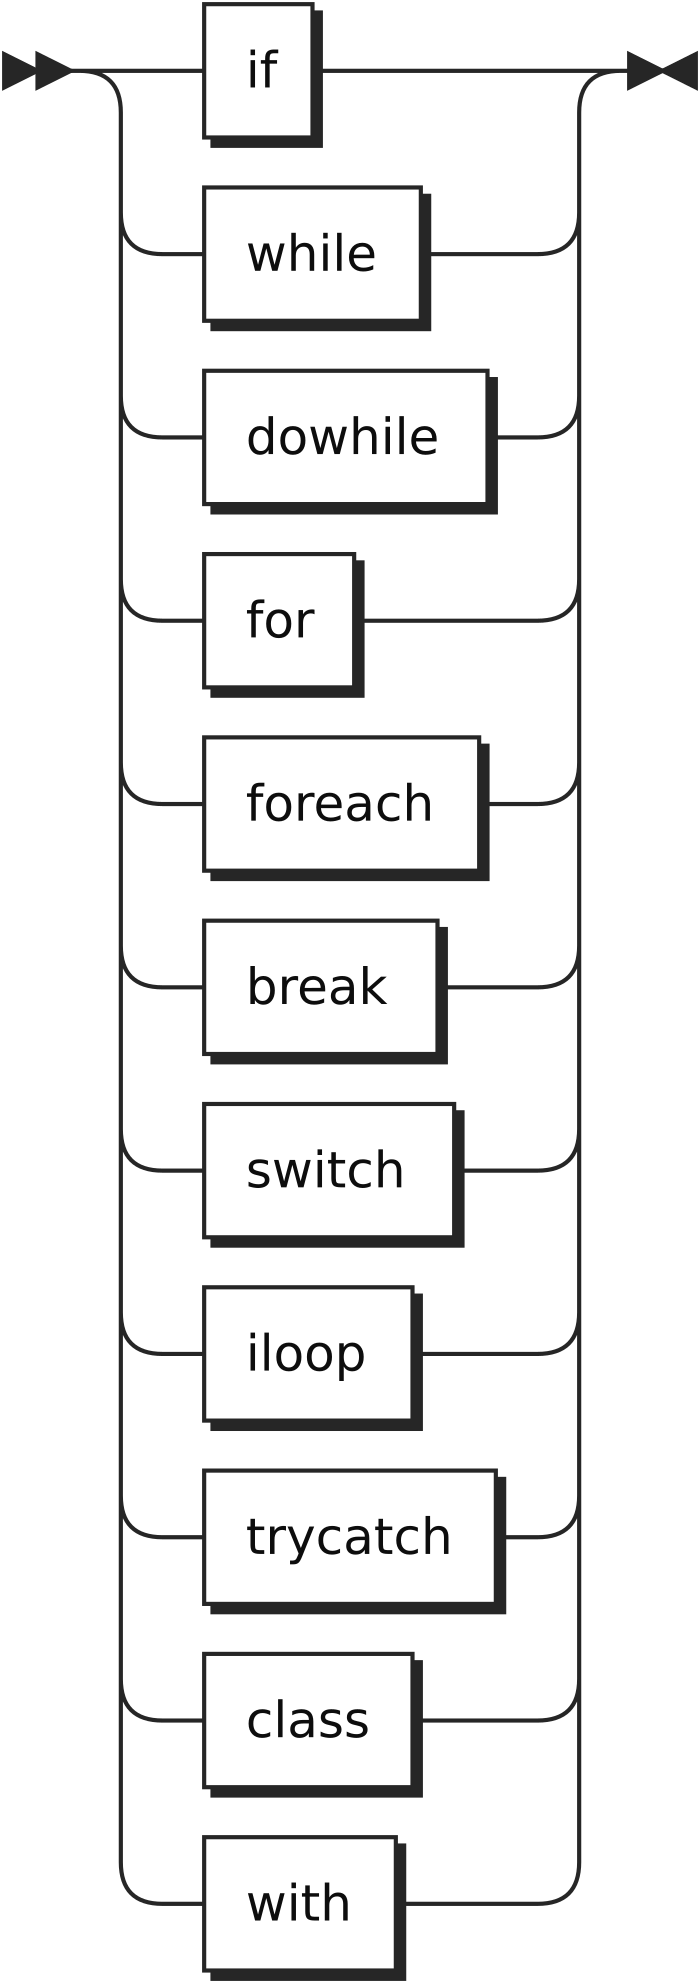
stmtb ::=   if
         |  while
         |  dowhile
         |  for
         |  foreach
         |  break
         |  switch
         |  iloop
         |  trycatch
         |  class
         |  with
Sentencia de control: if
[style=nonumbers,
    basicstyle=\tiny, %or \small or \footnotesize etc.
]
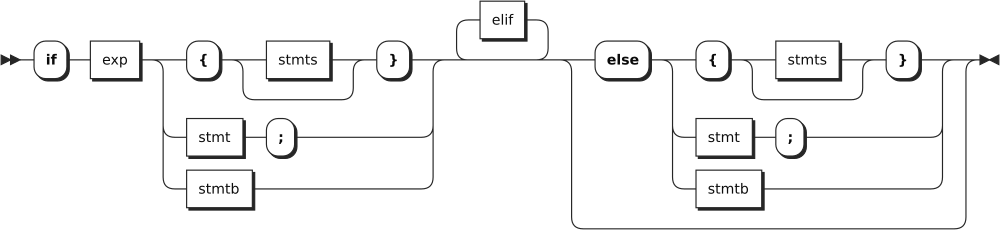
if ::= "if" exp ("{" stmts? "}" | stmt ";" | stmtb) elif* ("else" ("{" stmts? "}" | stmt ";" | stmtb))?

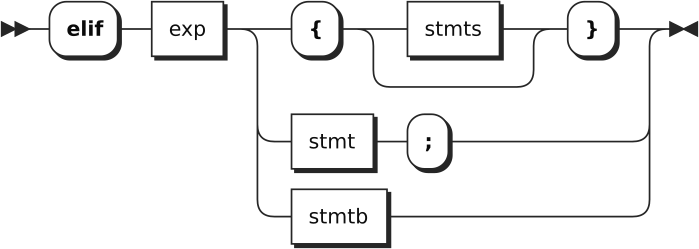
elif ::=  "elif" exp ( "{" stmts? "}" | stmt ";" | stmtb )
Sentencia de control: while
[style=nonumbers,
    basicstyle=\tiny]
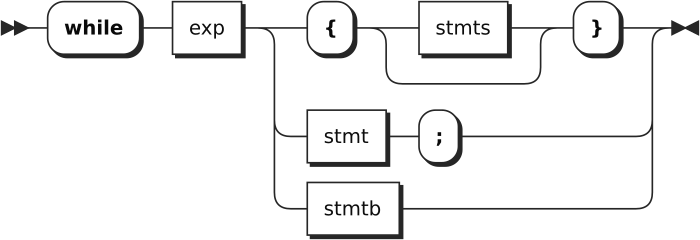
while ::=
   "while" exp ("{" stmts? "}" | stmt ";" | stmtb)
Sentencia de control: do...while
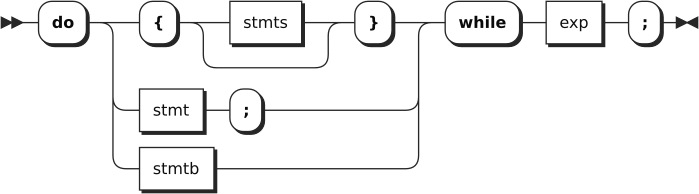
dowhile ::= "do" ( "{" stmts? "}" | stmt ";" | stmtb ) "while" exp ";"
Sentencia de control: for
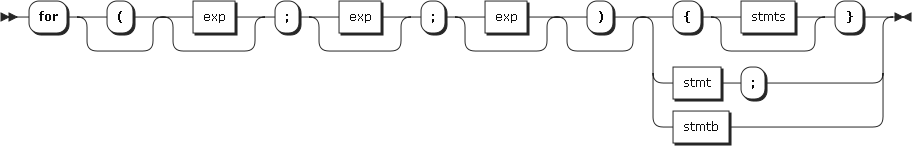
for ::= "for" "("? exp? ";" exp? ";" exp? ")"? ( "{" stmts? "}" | stmt ";" | stmtb )
Sentencia de control: forearch
[style=nonumbers,basicstyle=\tiny]
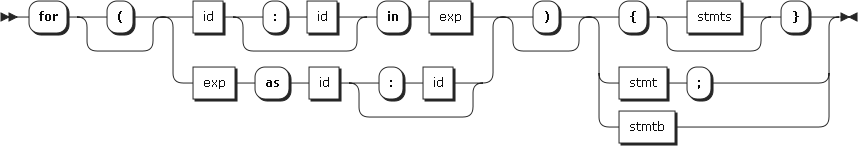
foreach ::=
   "for" "("?(id (":" id)? "in" exp | exp "as" id (":" id)?)")"? ("{" stmts? "}" | stmt ";" | stmtb)
Sentencia de control: switch
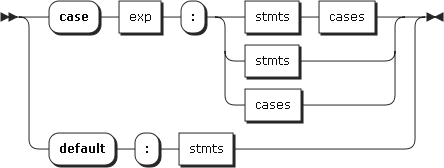
switch ::= "switch" "(" exp ")" "{" cases? "}"

cases ::= "case" exp ":" ( stmts cases | stmts | cases )
   |  "default" ":" stmts
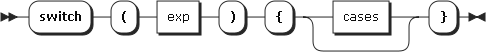
Sentencia de control: iloop
[style=nonumbers,basicstyle=\tiny]
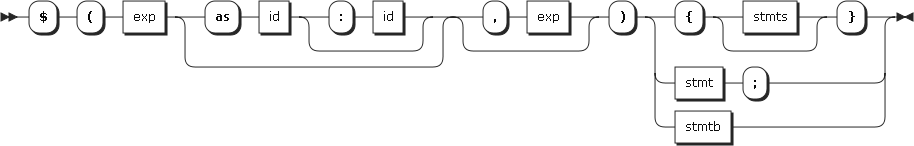
iloop ::= "$" "(" exp ( "as" id (":" id)? )? ("," exp )? ")" ( "{" stmts? "}" | stmt ";" | stmtb )

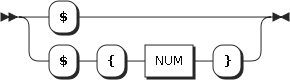
iloop_access ::=  "$"
               |  "$" "{" NUM "}"
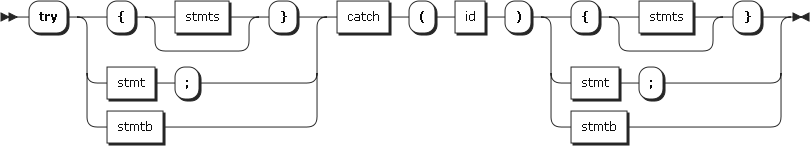
Sentencia de control: try...catch
[style=nonumbers,basicstyle=\tiny]
trycatch ::=
 "try" ( "{" stmts? "}" | stmt ";" | stmtb ) catch "(" id ")" ( "{" stmts? "}" | stmt ";" |  stmtb )
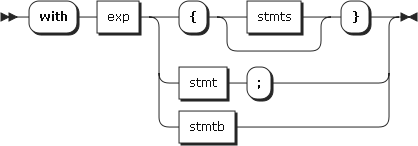
Sentencia de control: with
[style=nonumbers,basicstyle=\tiny]
with ::=
 "with" exp ( "{" stmts? "}" | stmt ";" | stmtb )
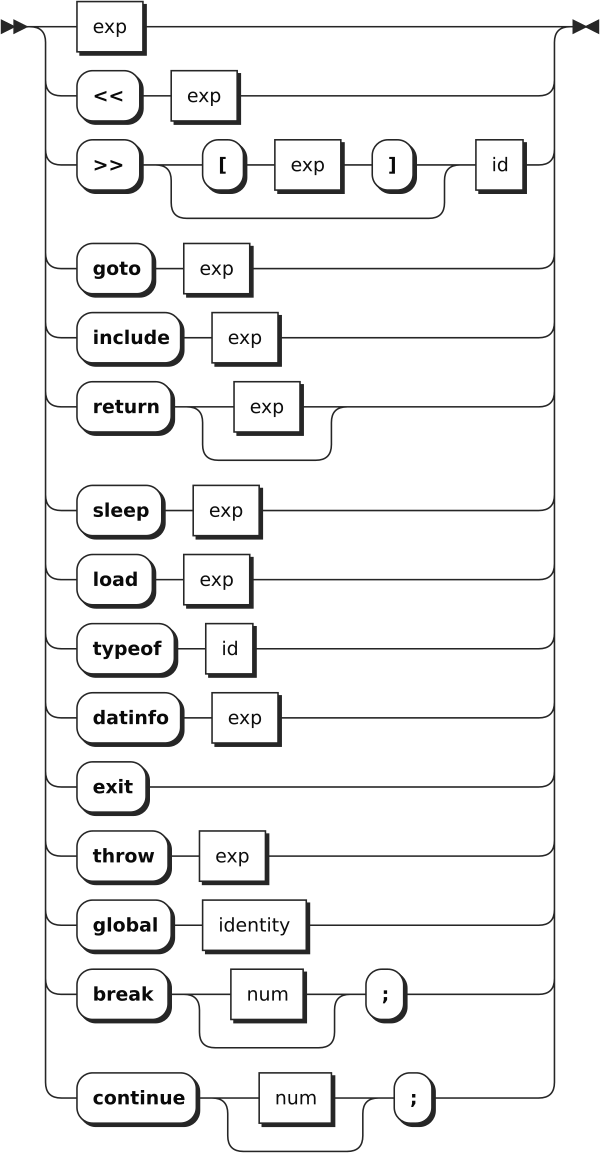
Sentencia simple
stmt  ::=   exp
         |  "<<" exp
         |  ">>" ("[" exp "]")? id
         |  "goto" exp
         |  "include" exp
         |  "return" exp?
         |  "sleep" exp
         |  "load" exp
         |  "typeof" id
         |  "datinfo" exp
         |  "exit"
         |  "throw" exp
         |  "global" identity
         |  "break" num? ";"
         |  "continue" num? ";"
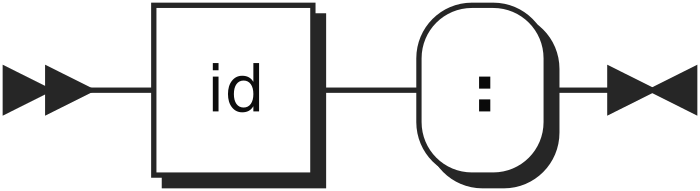
Etiquetas
label ::= id ":"
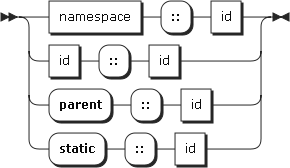
Nombres de espacios
[style=nonumbers, basicstyle=\tiny]
namespace ::=  namespace "::" id
            |  id "::" id
            |  "parent" "::" id
            |  "static" "::" id
Clases
class ::= "class" id ("extends" id )? "{" class_stmts? "}"

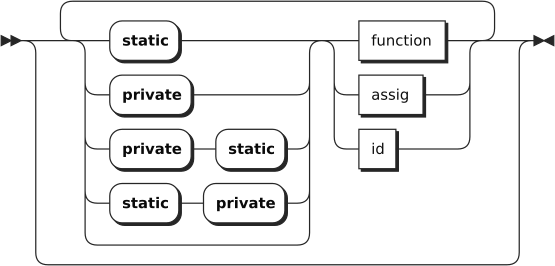
Métodos y atributos
class_stmts ::=
   (("static"|"private"|"private" "static"|"static" "private")? (function|id|assig))*
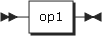
Expresiones
exp ::= op1
Operadores lógicos
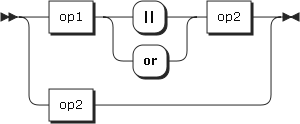
Or lógico
op1 ::=  op1 ( "||" | "or" ) op2
      |  op2
And lógico
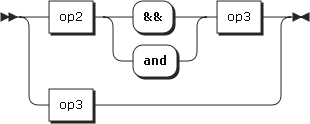
op2 ::=  op2 ( "&&" | "and" ) op3
      |  op3
Negación lógica
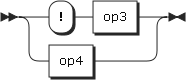
op3 ::=  "!" op3
      |  op4
Comparaciones
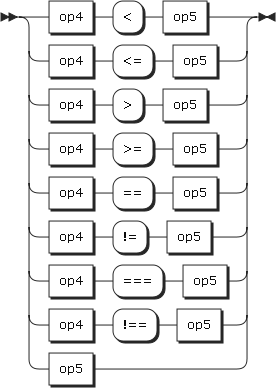
op4 ::=  op4 "<" op5
      |  op4 "<=" op5
      |  op4 ">" op5
      |  op4 ">=" op5
      |  op4 "==" op5
      |  op4 "!=" op5
      |  op4 "===" op5
      |  op4 "!==" op5
      |  op5
Operadores aritméticos
Suma y diferencia
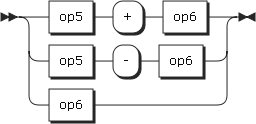
op5 ::= op5 "+" op6
      |  op5  "-" op6
      |  op6
Producto y división
op6  ::= op6 "*" op7
      |  op6 "/" op7
      |  op7
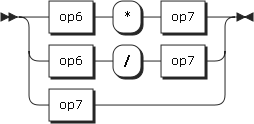
Potencia y módulo
op7  ::= op7 "^" op8
      |  op7 "%" op8
      |  op8
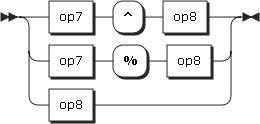
Operadores cadenas de caracteres
Concatenación
op8 ::=  op8 "." op9
      |  op9
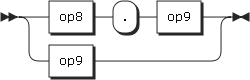
Flujo
op9  ::= call "<<" op9
      |  call
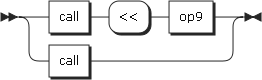
Llamadas
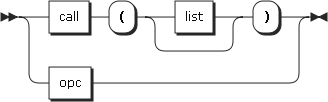
call ::= call "(" list? ")"
      |  opc
Operadores condicionales
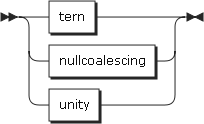
opc ::=  tern
      |  nullcoalescing
      |  unity
Operador ternario
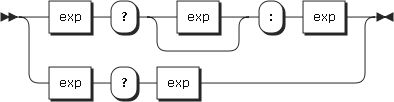
tern ::= exp "?" exp? ":" exp
   |  exp "?" exp
Null coalescing
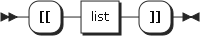
nullcoalescing ::= "[[" list "]]"
Operadores unitarios
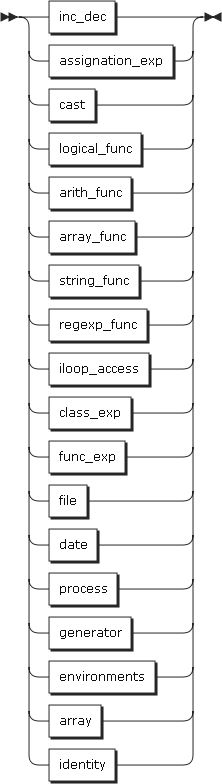
unity ::=   inc_dec
         |  assignation_exp
         |  cast
         |  logical_func
         |  arith_func
         |  array_func
         |  string_func
         |  regexp_func
         |  iloop_access
         |  class_exp
         |  func_exp
         |  file
         |  date
         |  process
         |  generator
         |  environments
         |  array
         |  identity
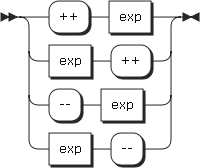
Incrementos y decrementos
inc_dec ::= "++" exp
         |  exp "++"
         |  "--" exp
         |  exp "--"
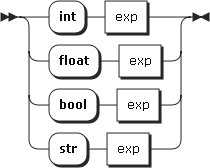
Conversión de tipos
cast ::= "int" exp
      |  "float" exp
      |  "bool" exp
      |  "str" exp
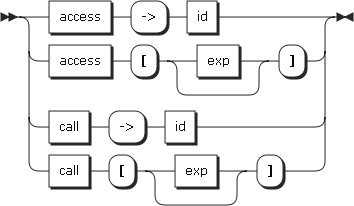
Accesos
[style=nonumbers, basicstyle=\tiny]
access ::=  access "->" id
         |  access "[" exp? "]"
         |  call "->" id
         |  call "[" exp? "]"
Asignaciones
[style=nonumbers, basicstyle=\tiny]
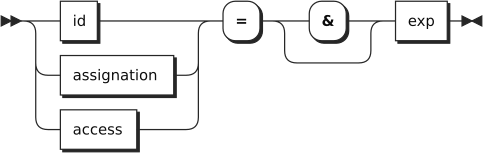
assignation ::=
 (id | assignation | access)  "=" "&"? exp
Funciones
function ::= "~" id "(" params_val? ")" "{" stmts? "}"

Función lambda
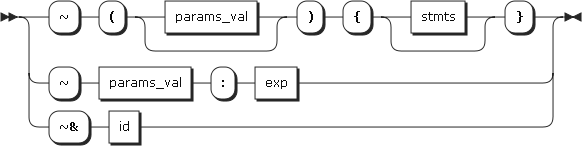
function_lambda ::= "~" "(" params_val? ")" "{" stmts? "}"
    | "~" params_val ":" exp
    | "~&" id
Cálculo parcial
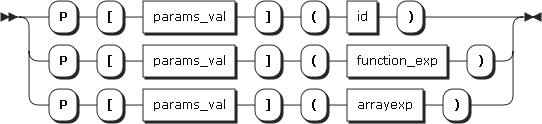
function_partial ::= "P" "[" params_val "]" "(" id ")"
   |  "P" "[" params_val "]" "(" function_exp ")"
   |  "P" "[" params_val "]" "(" arrayexp ")"
Función de contexto
function_context ::= "~>"

Decoradores
decorator ::= "~~" id "(" params_val? ")" "{" stmts? "}"

Decorador lambda
decorator_lambda ::= "~~" "(" params_val? ")" "{" stmts? "}"

Operadores clases y objetos
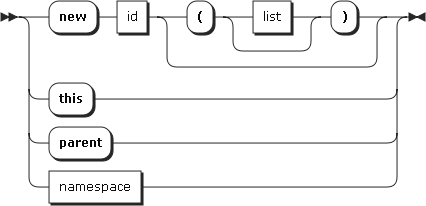
class_exp ::=  "new" id ("(" list? ")")?
            |  "this"
            |  "parent"
            |  namespace
Funciones del lenguaje
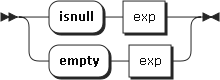
Funciones lógicas
logical_func ::=  "isnull" exp
               |  "empty" exp
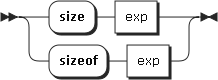
Funciones aritméticas
arith_func ::= "size" exp
            |  "sizeof" exp
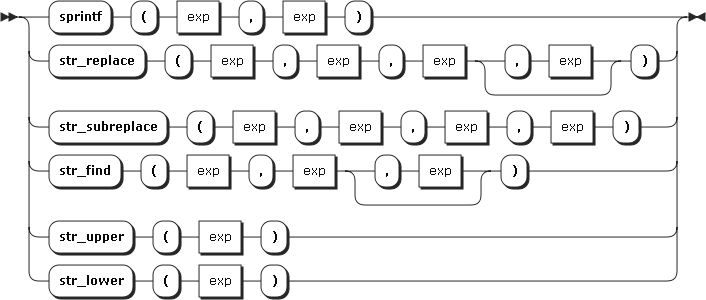
Funciones cadenas de caracteres
string_func ::=   "sprintf" "(" exp "," exp ")"
               |  "str_replace" "(" exp "," exp "," exp ("," exp)? ")"
               |  "str_subreplace" "(" exp "," exp "," exp "," exp ")"
               |  "str_find" "(" exp "," exp ("," exp)? ")"
               |  "str_upper" "(" exp ")"
               |  "str_lower" "(" exp ")"
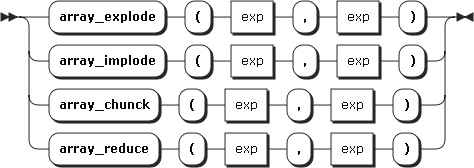
Funciones arrays
array_func ::=
 "array_explode" "(" exp "," exp ")"
 |  "array_implode" "(" exp "," exp ")"
 |  "array_chunck" "(" exp "," exp ")"
 |  "array_reduce" "(" exp "," exp ")"
Funciones expresiones regulares
regexp_func ::=   "regexp" "(" exp ")"
               |  "search" "(" exp "," exp ("," list)? ")"
               |  "match" "(" exp "," exp ")"
Funciones fechas y tiempo
date ::= "date" "(" exp ")"
      |  "time" ("(" ")")
Funciones acceso a entorno
environment ::= "getenv" "(" exp ")"
Funciones ficheros
[style=nonumbers, basicstyle=\tiny]
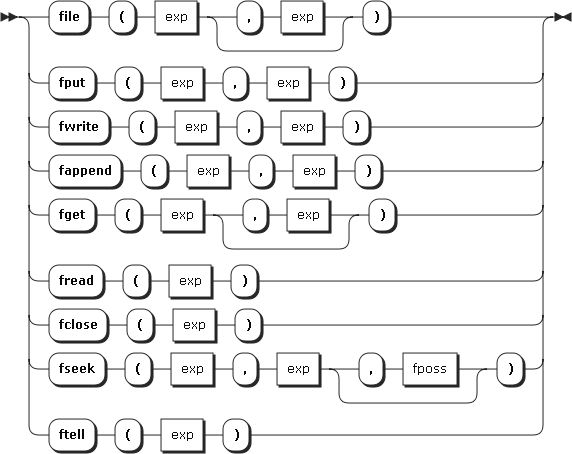
file ::= "file" "(" exp ("," exp)? ")"
   |  "fput" "(" exp "," exp ")"
   |  "fwrite" "(" exp "," exp ")"
   |  "fappend" "(" exp "," exp ")"
   |  "fget" "(" exp ("," exp)? ")"
   |  "fread" "(" exp ")"
   |  "fclose" "(" exp ")"
   |  "fseek" "(" exp "," exp ("," fposs)? ")"
   |  "ftell" "(" exp ")"

fpos ::= FSET
      |  FCUR
      |  FEND
Funciones procesos
[style=nonumbers, basicstyle=\tiny]
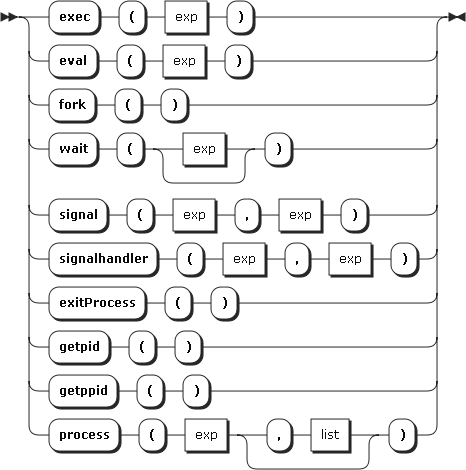
process ::= "exec" "(" exp ")"
         |  "eval" "(" exp ")"
         |  "fork" "(" ")"
         |  "wait" "(" exp? ")"
         |  "signal" "(" exp "," exp ")"
         |  "signalhandler" "(" exp "," exp ")"
         |  "exitProcess" "(" ")"
         |  "getpid" "(" ")"
         |  "getppid" "(" ")"
         |  "process" "(" exp ("," list)? ")"
Generadores
[style=nonumbers, basicstyle=\tiny]
generator ::= "(" exp (":" exp)? "for" id (":" id )? "in" exp ( "if" exp )? ("{" stmts "}")? ")"
   | "(" exp (":" exp)? "for" "(" id (":" id )? "in" exp ")" ( "if" exp )? ("{" stmts "}")? ")"

Identidades
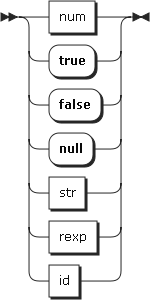
identity ::=   num
            |  "true"
            |  "false"
            |  "null"
            |  str
            |  rexp
            |  id
Parámetros
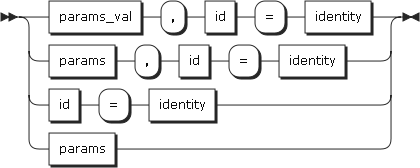
params_val ::= params_val "," id "=" identity
   |  params "," id "=" identity
   |  id "=" identity
   |  params

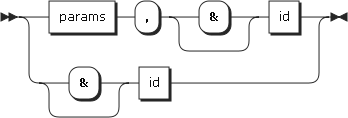
params ::= params "," "&"? id
   |  "&"? id
Listas y pares
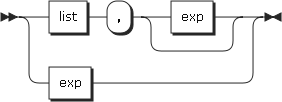
list ::= list "," exp?
      |  exp
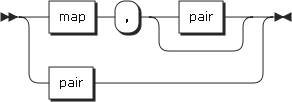
map ::=  map "," pair?
      |  pair

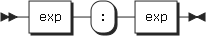
pair ::= exp ":" exp
Identificador
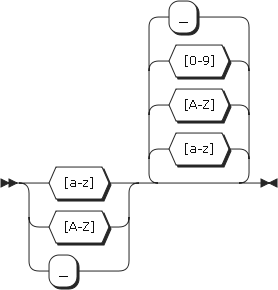
id ::= [a-zA-Z_][a-zA-Z0-9_]*
Números
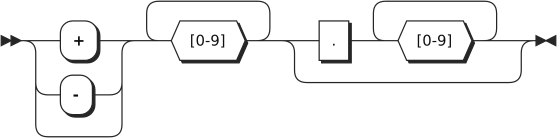
num ::= ("+"|"-"|) [0-9]+(.[0-9]+)?
Cadenas de caracteres
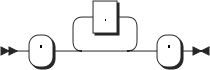
str ::= "'".* "'"
Array
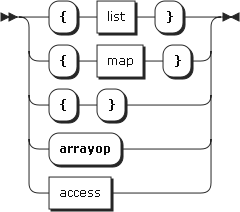
array ::=   "{" list "}"
         |  "{" map "}"
         |  "{""}"
         |  "arrayop"
         |  access
Expresión regular
regexp ::= "`".*"`"
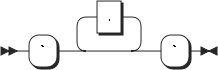
Comentarios
comments ::=   "/*" [^*]* "*/"
            |  "//"[^\n]
            |  "#" [^#]
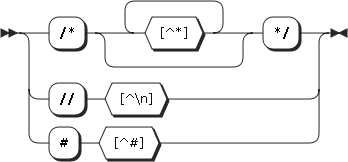
Diseño de comunicaciones
OMI puede ser ejecutado de forma que guarde en un fichero una estructura de datos que representa el proceso de interpretación seguido. Esta estructura de datos tiene un formato JSON. En esta sección se presenta la estructura de estos ficheros mediante el esquema de json-schema.org.Cuando el intérprete se ejecuta en modo servidor se vale de esta misma estructura para devolver el estado del proceso. Otros sistemas que hagan de cliente pueden interpretar esta estrucutra de datos para operar con los mismos.
Esquema JSON
Nodos ejecutables
La primera estructura de datos JSON que es guardada representa el árbol fruto del análisis léxico y sintáctico. Esta estructura de datos tiene como elemento base un nodo que mantendrá relaciones con otros nodos. A partir del nodo raíz se puede obtener todo el árbol de nodos.
{
   "$schema": "/json-schema/node",
   "title": "Nodos del ábol sintáctico"
   "type": "object",
   "properties": {
      "id": {
        "description": "Posición de memoria del nodo",
        "type" : "string",
      },
      "name": {
         "description": "Nombre del nodo",
         "type": "string",
      },
      "type": {
         "description": "Tipo del nodo",
         "type": "string",
      },
      "size": {
         "description": "Tamaño del nodo en Bytes",
         "type": "string",
      },
      "rel": {
         "description": "Relaciones con otros nodos",
         "type": "array",
         "items": {
            "ref":  "/json-schema/node"
         }
      },
      "relname": {
         "description": "Nombre de las relaciones con otros nodos",
         "type": "array",
         "items": {
            "type":  "string",
         }
      },
   }
}
Acciones
Para representar el proceso de interpretación se precisa de una estructura de datos que indique las acciones llevadas a cabo en el proceso.
{
   "$schema": "/json-schema/process",
   "title": "Proceso de interpretación",
   "type": "array",
   "items": {
      "type": "object",
        "properties": {
            "action": {
               "description": "Acción que se corresponde con un paso",
               "type": "enum",
            },
            "id": {
               "description": "Id del nodo sobre el que se lleva a cabo la acción",
               "type": "string",
            },
            "attrs": {
               "description": "Atributos de la accón. Dependen de la acción".
               "type": "object",
            }
      }
   }
}
Los tipos de acciones son los siguientes:
- run:
- Ejecución de un nodo.
- runClass:
- Ejecución de un nodo clase.
- endClass:
- Finaliza la ejecución de una clase.
- setParent:
- Establece el padre de un nodo clase.
- setValue:
- Establece el valor de un nodo.
- setRef:
- Establece el valor de una referencia.
- accessVar:
- Accede al valor de una variable.
- accessFunc:
- Accede al valor de una funcion.
- accessClass:
- Accede al valor de una clase.
- clone:
- Clona un nodo.
- newNode:
- Crea un nuevo nodo.
- changeRef:
- Cambia el valor de una referencia.
- changeValue:
- Cambia el valor de un nodo.
- delete:
- Elimina un nodo.
- print:
- Imprime en la salida estándar.
- input:
- Toma valores de la entrada estándar.
- toSymbols:
- Añade elementos a la tabla de símbolos interna de un nodo.
- removeLevel:
- Elimina un nivel de la tabla de símbolos.
- return:
- Se devuelve un valor.
- error:
- Se ha producido un error.
- sleep:
- Se espera un evento.
- runStatic:
- Comienza la ejecución de un elemento estático.
- endStatic:
- Finaliza la ejecución de un elemento estático.
- runPrivate:
- Comienza la ejecución de un elemento privado.
- endPrivate:
- Finaliza la ejecución de un elemento privado.
- runGlobal:
- Comienza la ejecución de un elemento global.
- endGlobal:
- Finaliza la ejecución de un elemento global.
- line:
- Especifica la línea actual del código fuente.
Diseño de componentes
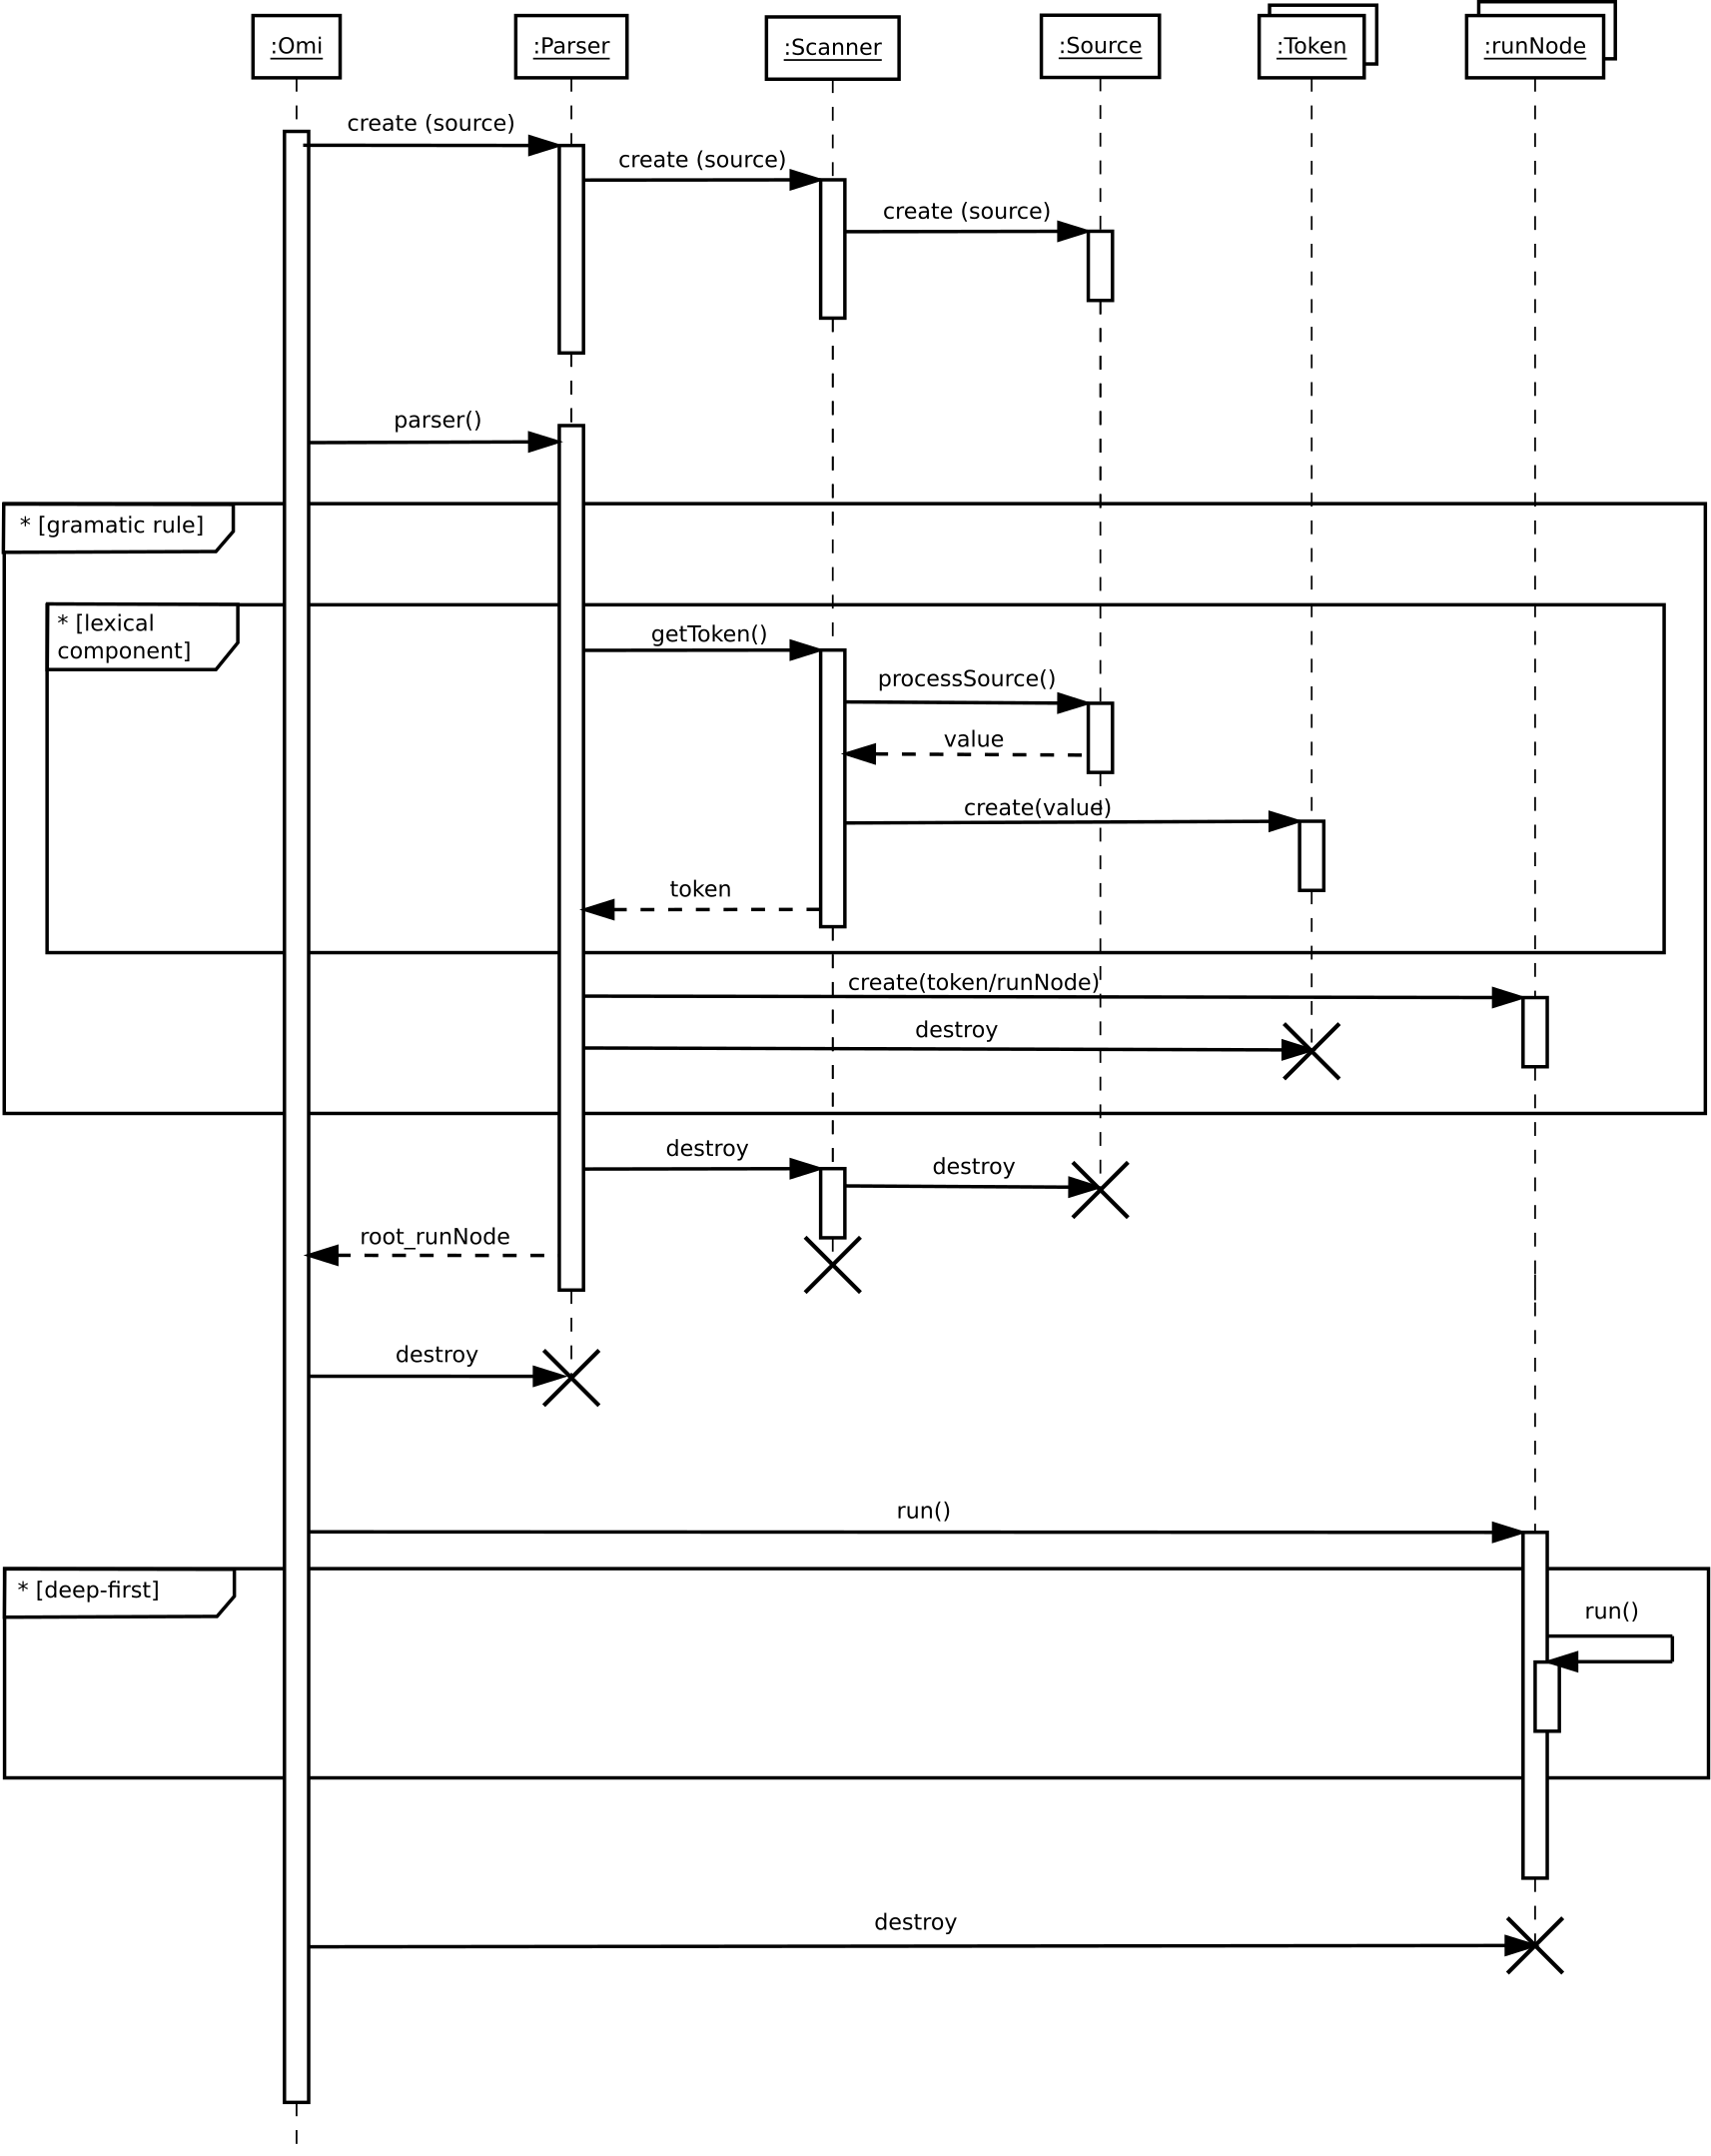
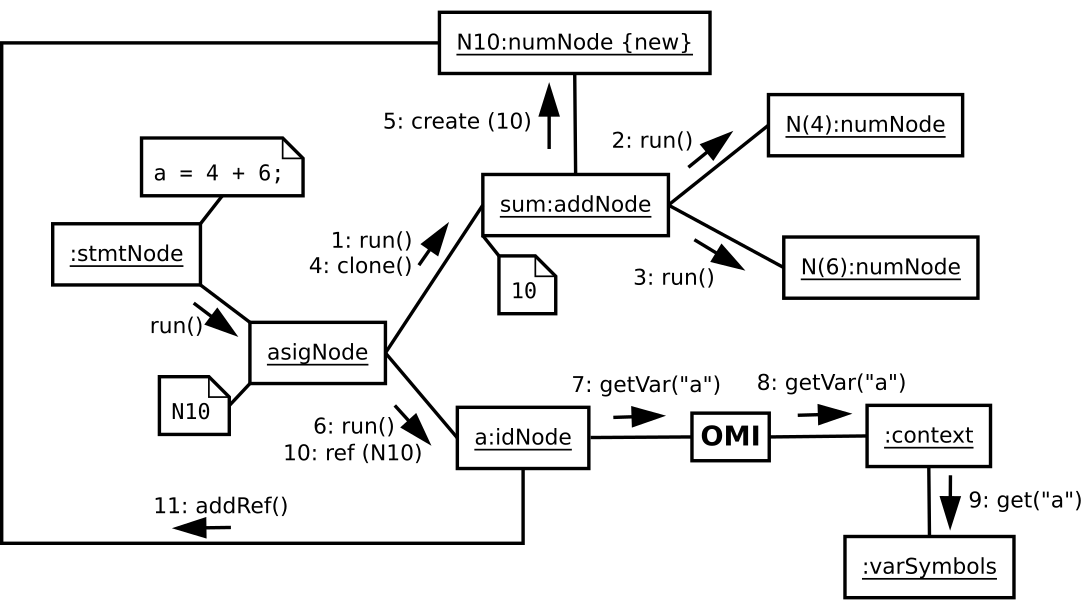
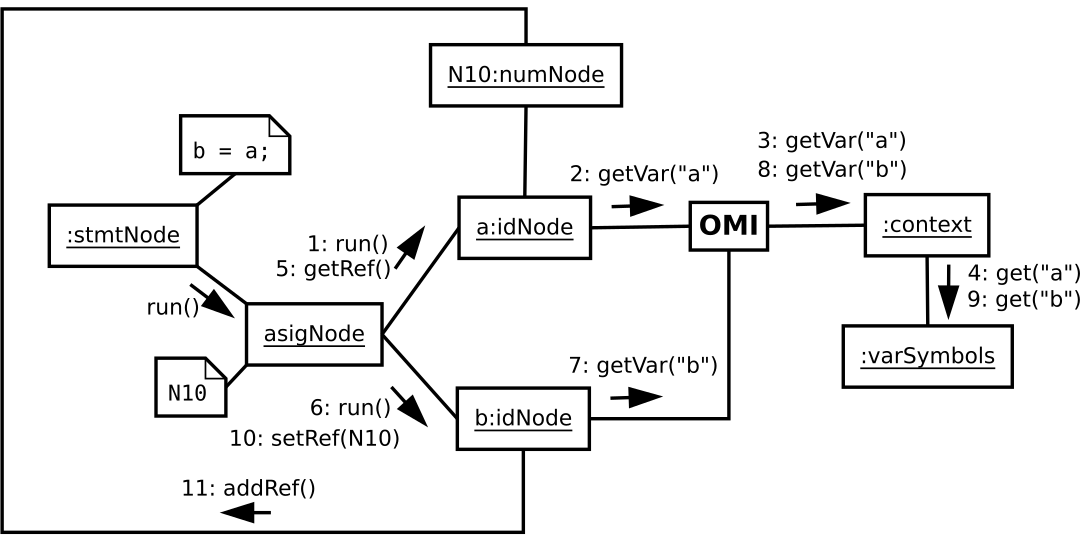
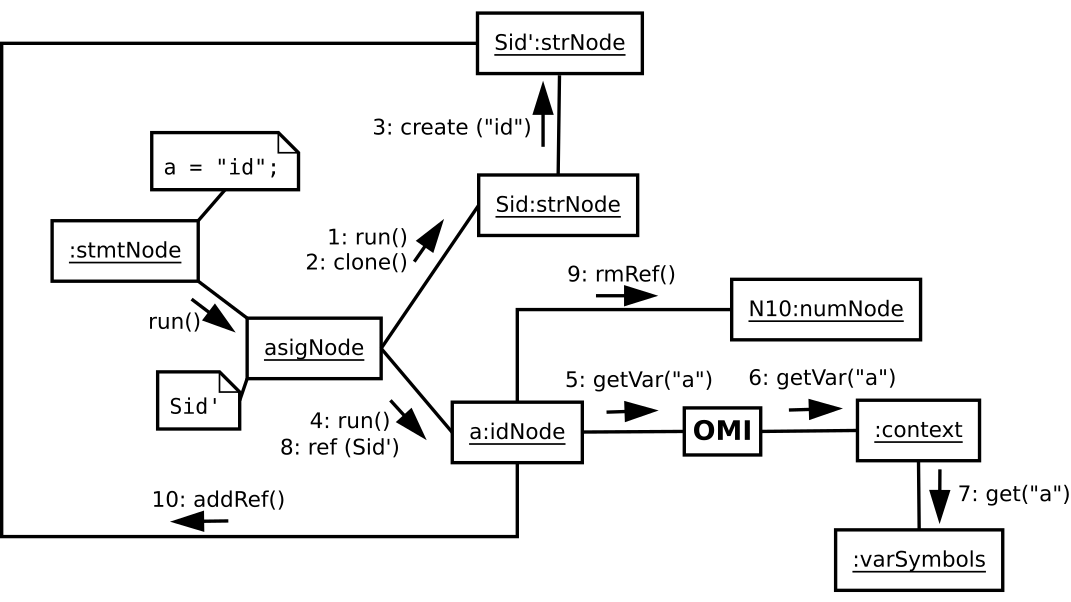
El presente documento constituye el modelo de comportamiento básico. Este detalla cómo los distintos objetos interaccionan y se comunican entre sí para analizar la entrada del usuario, correspondiente el código fuente, e interpretarlo para su ejecución.Se presenta un diagrama de secuencia para la operación interpretación de un código fuente. Luego se presenta diagramas de comunicación correspondientes a algunas sentencias escritas en el lenguaje.
Interpretar código fuente
Para la interpretación de código fuente el sistema crea los objetos encargados del análisis léxico y sintáctico del mismo. El objeto principal del sistema se encarga de crear e inicializar el analizador sintáctico (parser) a partir del código fuente, a su vez este crea el analizador léxico (scanner) que crea una estructura correspondiente al código fuente que será interpretado.El sistema envía un mensaje para que el parser analice el código fuente. El analizador sintáctico define una serie de reglas gramaticales e irá comprobando que el código fuente cumple estas reglas a la vez que las utiliza para crear un árbol de derivación denominado árbol sintáctico. Para ello hace uso de una serie de tokens que irá solicitando al analizador léxico. Este último obtendrá los tokens a partir del código fuente, mediante una serie de reglas léxicas formadas a partir de lenguajes regulares. Por cada regla gramatical que se cumpla en el parser, este habrá obtenido del scanner tantos tokens como componentes léxicos sean necesarios para cumplir la regla. Además por cada regla gramatical se construirá un nodo ejecutable formado a partir del valor asociado a una serie de tokens, o a partir de otros nodos ejecutables construidos por reglas de mayor prioridad y creados en anteriores interacciones. Esto formará un árbol sintáctico formado por nodos ejecutables que contienen la semántica que encierran las construcciones del código fuente.
A partir del nodo raíz del árbol de nodos ejecutables comienza un recorrido en profundidad del árbol que conllevará la ejecución del código fuente, produciéndose así el resultado semántico esperado.
En el caso de que no se de una regla gramatical que se corresponda con el código analizado se producirá un error sintáctico. Por otro lado, en el caso de que alguna cadena contenida en el código fuente no se corresponda con los lenguajes regulares que define el scanner se producirá un error léxico.
Sentencias
Sentencia de control condicional
Operaciones aritméticas
Asignaciones
Diseño de la interfaz de usuario
En esta sección se describe el diseño de la interfaz del usuario a partir del análisis llevado a cabo.El intérprete presenta una interfaz de consola de comandos, por lo que el diseño se corresponde con una descripción de los usos del comando y el listado de las opciones que acepta.
El cliente runTree y la web en general presenta una interfaz web. El diseño se corresponde con una descripción gráfica de las páginas que la conforman y de las secciones que las componen.
Intérprete
El intérprete es un programa de consola de comando por lo que la interfaz con el usuario no es gráfica.El comando ``omi'' permite ejecutar el intérprete. Se puede usar de las siguientes forma:
- omi [opciones]
 [argumentos...]
- omi -c
 [argumentos...]
- omi -i [argumentos...]
- omi -sj
El listado de opciones que acepta el comando a continuación:
- -i
- : Ejecuta el intérprete de forma interactiva.
- -c
- : Interpreta el código dado.
- -l
- : Carga el módulo
.
- -h
- : Muestra la ayuda.
- -V
- : Muestra la versión.
- -j
- : Imprime una descripción del procesos en formato json en el fichero
.
- -x

- : Obtiene pasos del proceso de interpretación en cada petición.
- -s
- : Ejecuta como servidor en el puerto 8888.
runTree
runTree es un cliente web del intérprete OMI. Muestra información sobre el proceso de interpretación y permite navegar por este.
El sistema lo compone una única página web con un diseño de cuadrícula.
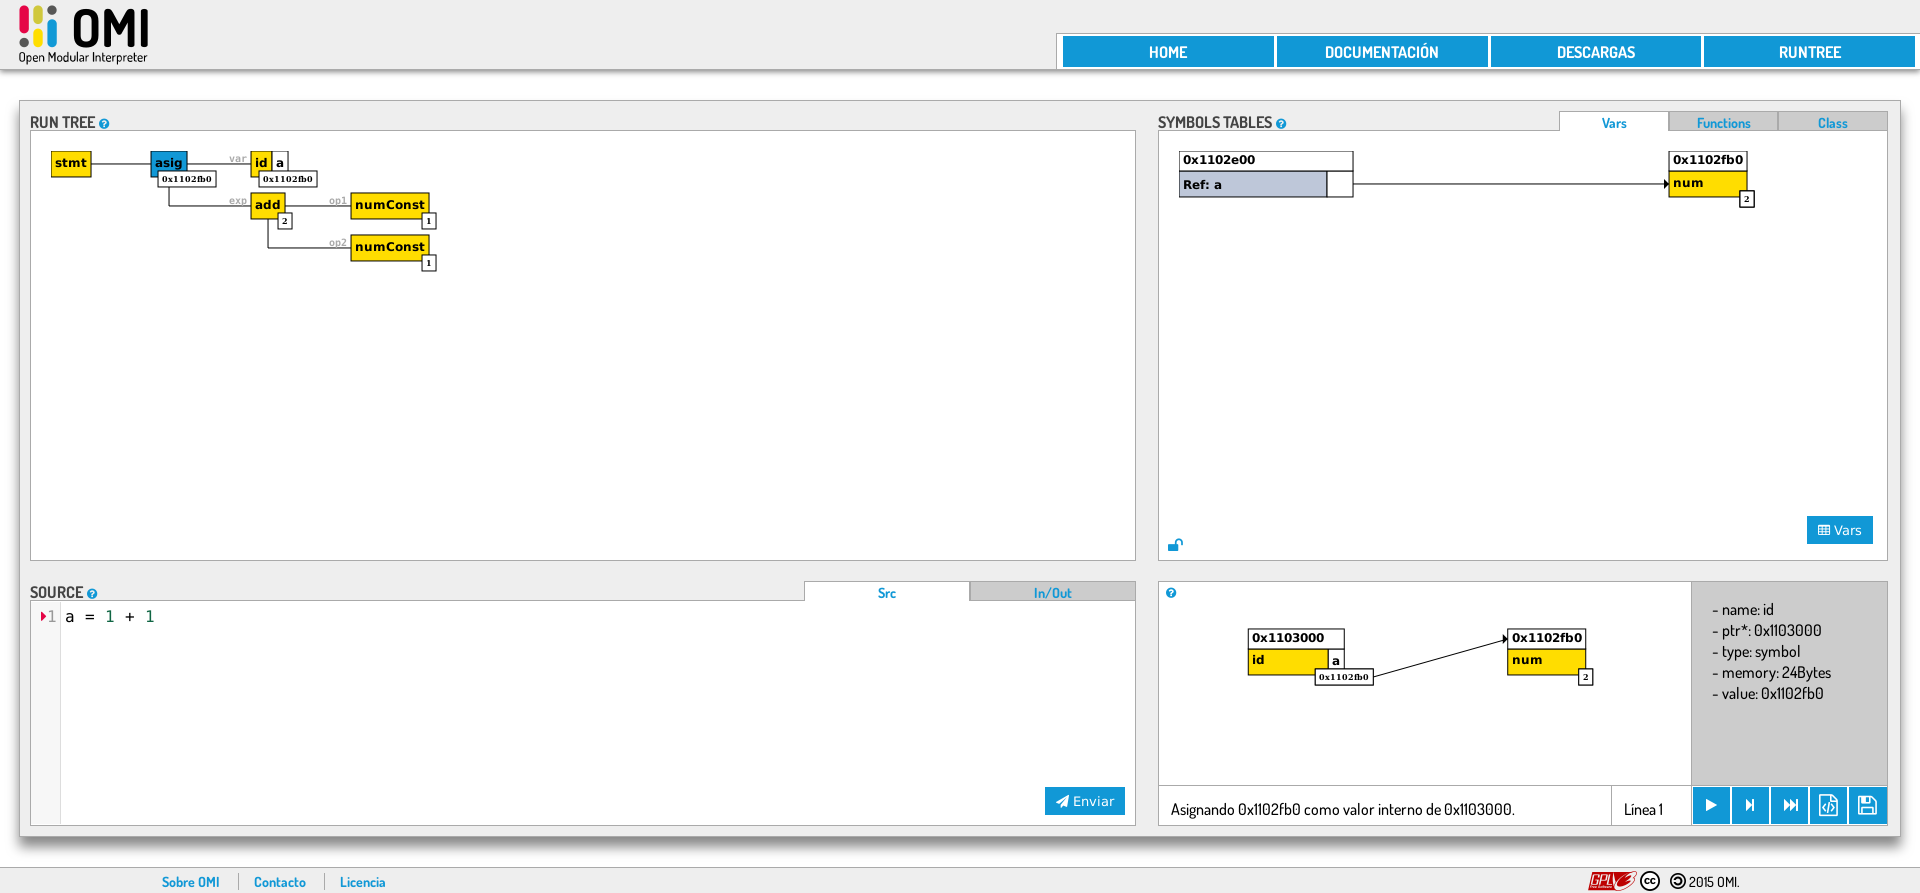
La primera parte de la retícula, superior izquierda, muestra el árbol sintáctico correspondiente al código enviado. En este árbol se marcarán los nodos a medida que se van ejecutando y resolviendo semánticamente. Además mostrará información directa de cada nodo tal como el nombre, el valor o el tipo.
En la segunda parte, superior derecha, muestra las tablas de símbolos de variables, funciones y clases. Esta sección permite navegar por las tablas de símbolos y los elementos que serán referenciados desde las mismas.
En la tercera parte, inferior izquierda, se muestra el código fuente y la interfaz de entrada/salida del programa.
En la última sección, inferior derecha, se muestra una consola informativa, en la que aparece una descripción del nodo actualmente en ejecución o los nodos seleccionados por el usuario. También se colocan en esta sección las opciones de control para avanzar un paso, una sentencia, la reproducción automática, abrir un fichero local o guardar el código en un fichero local.
Sitio web
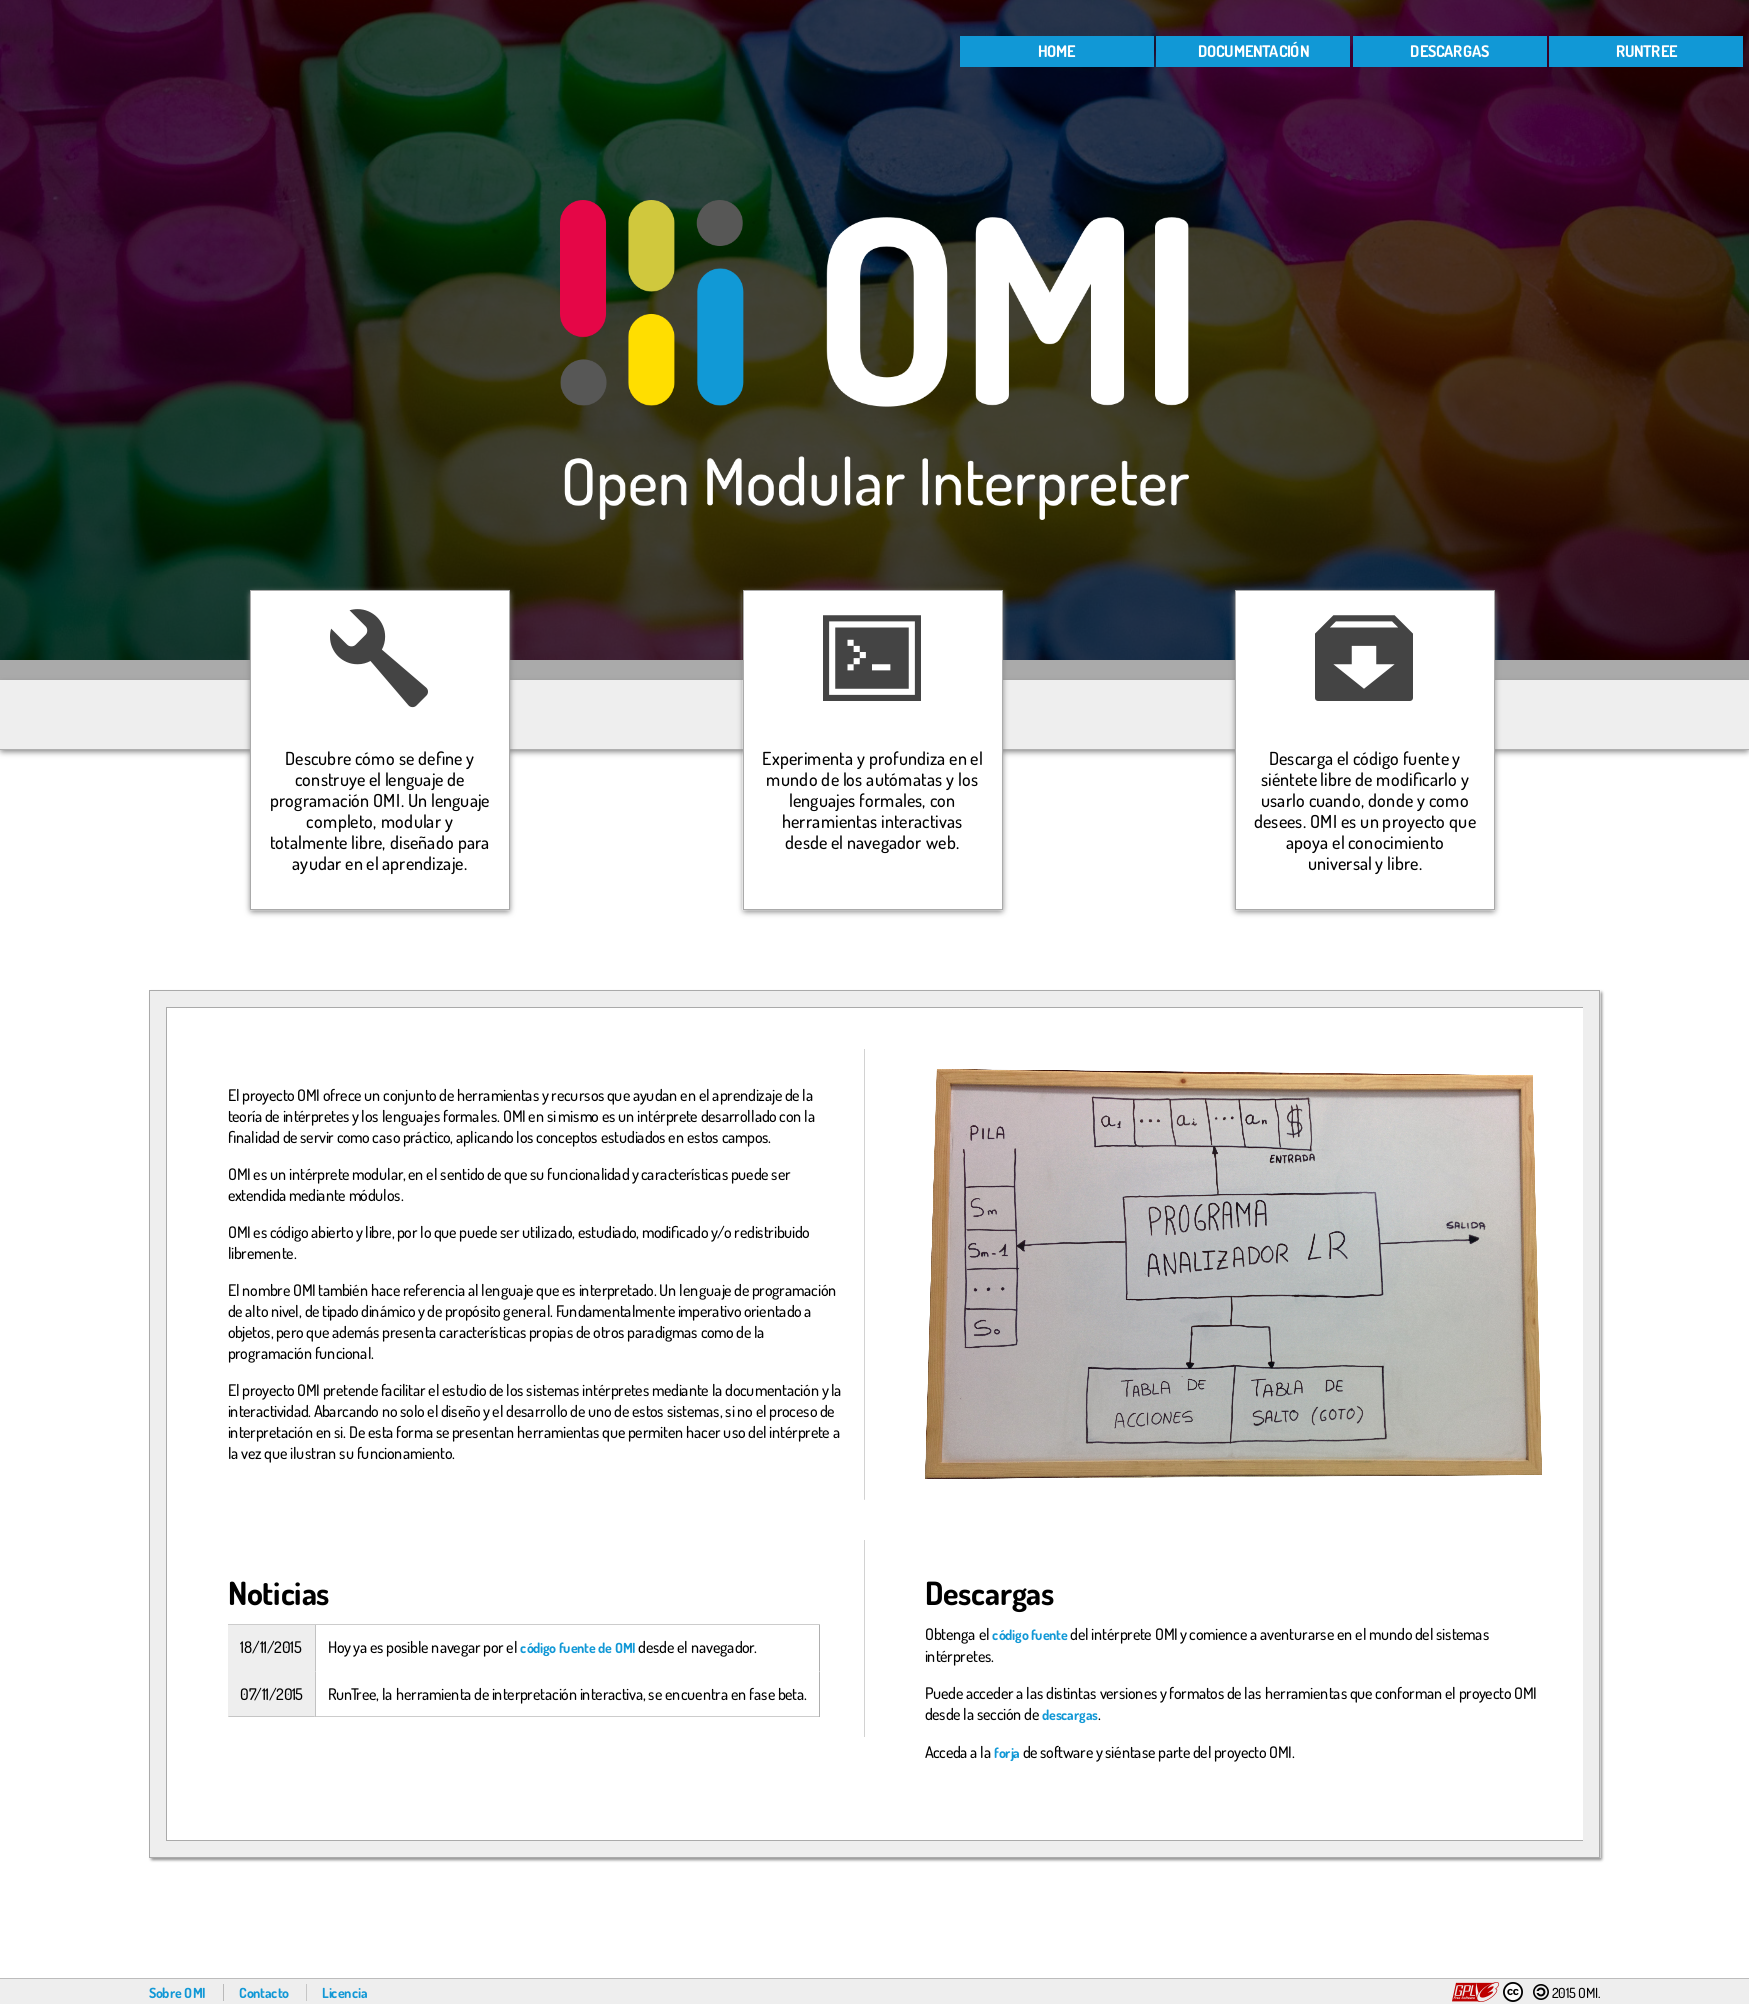
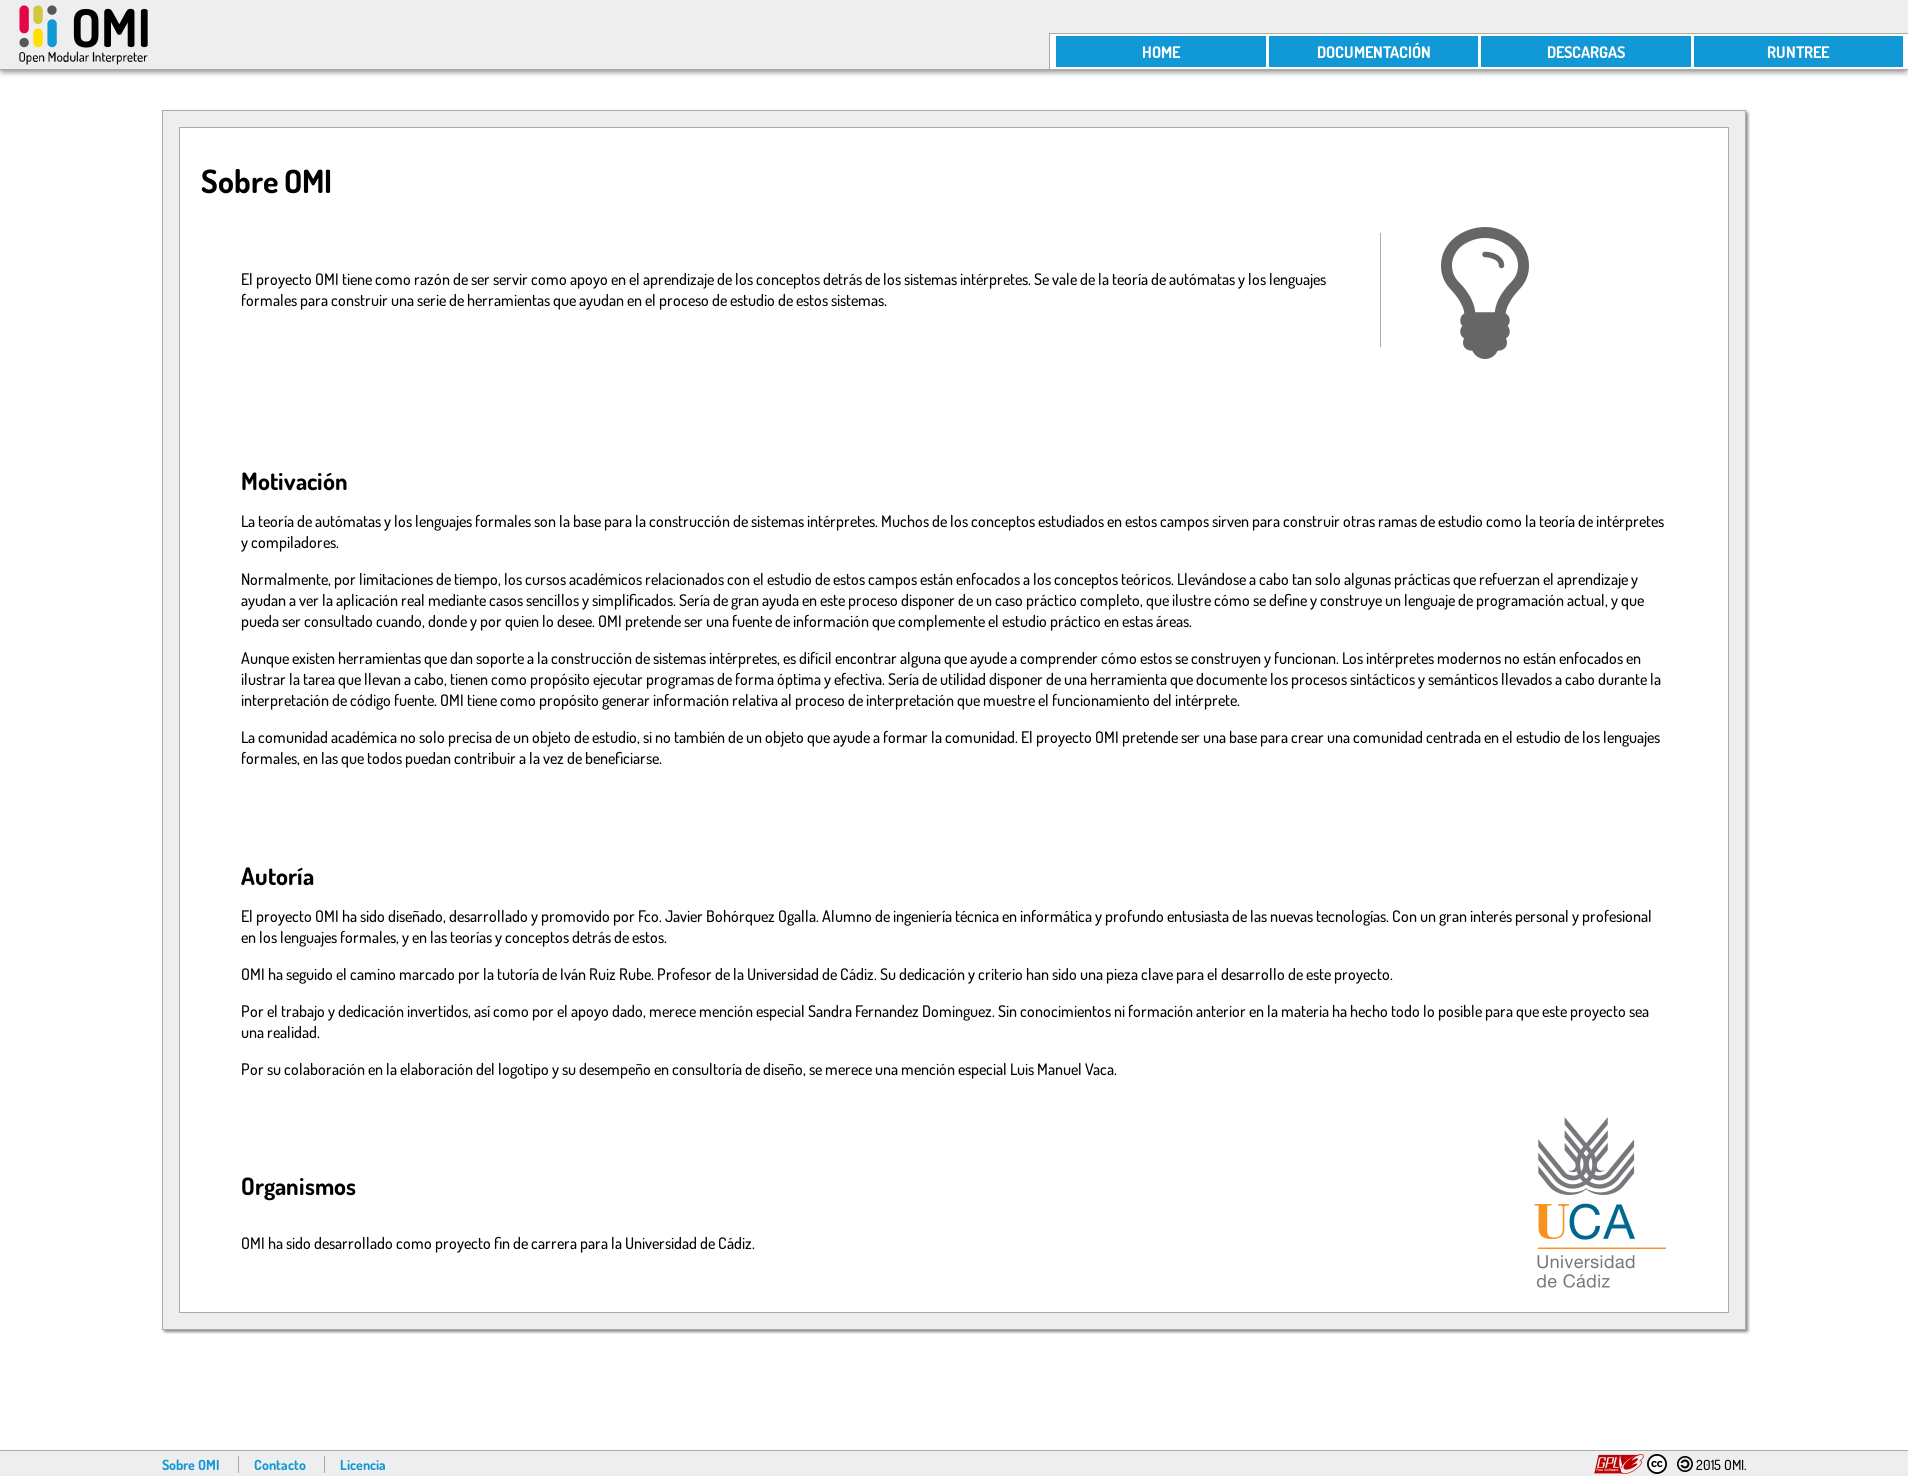
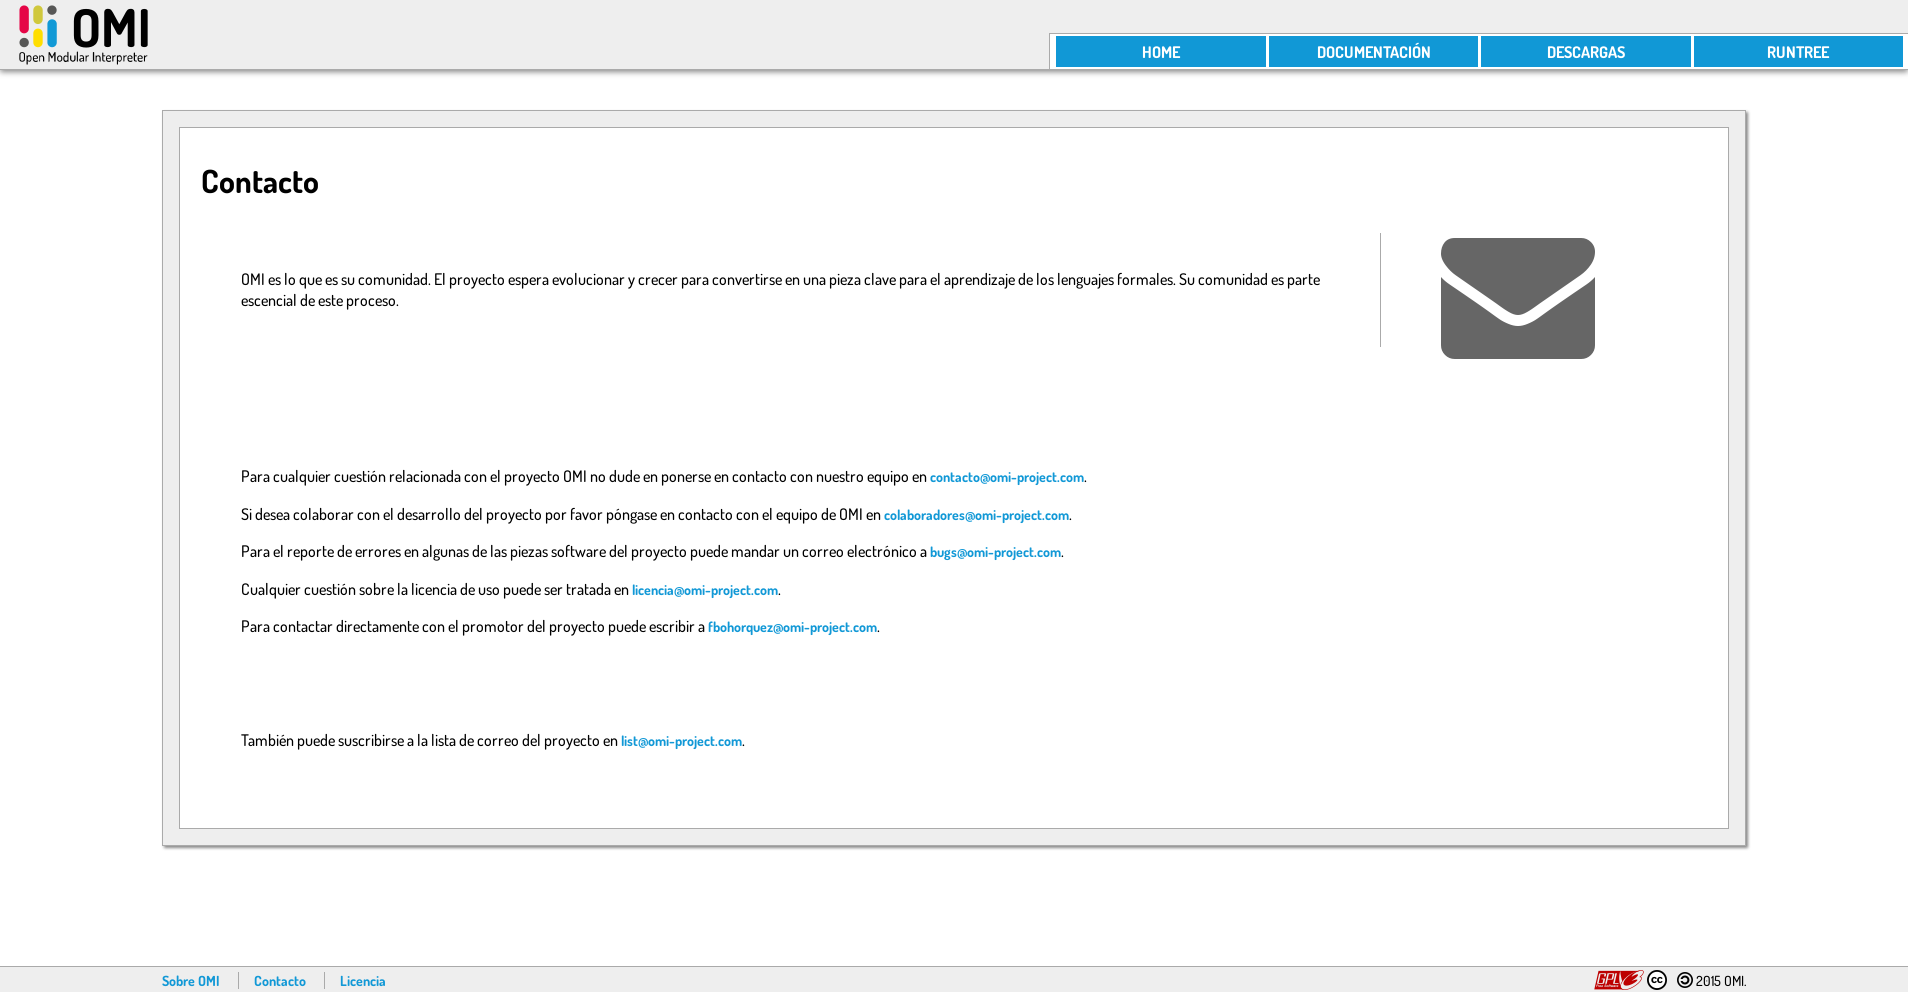
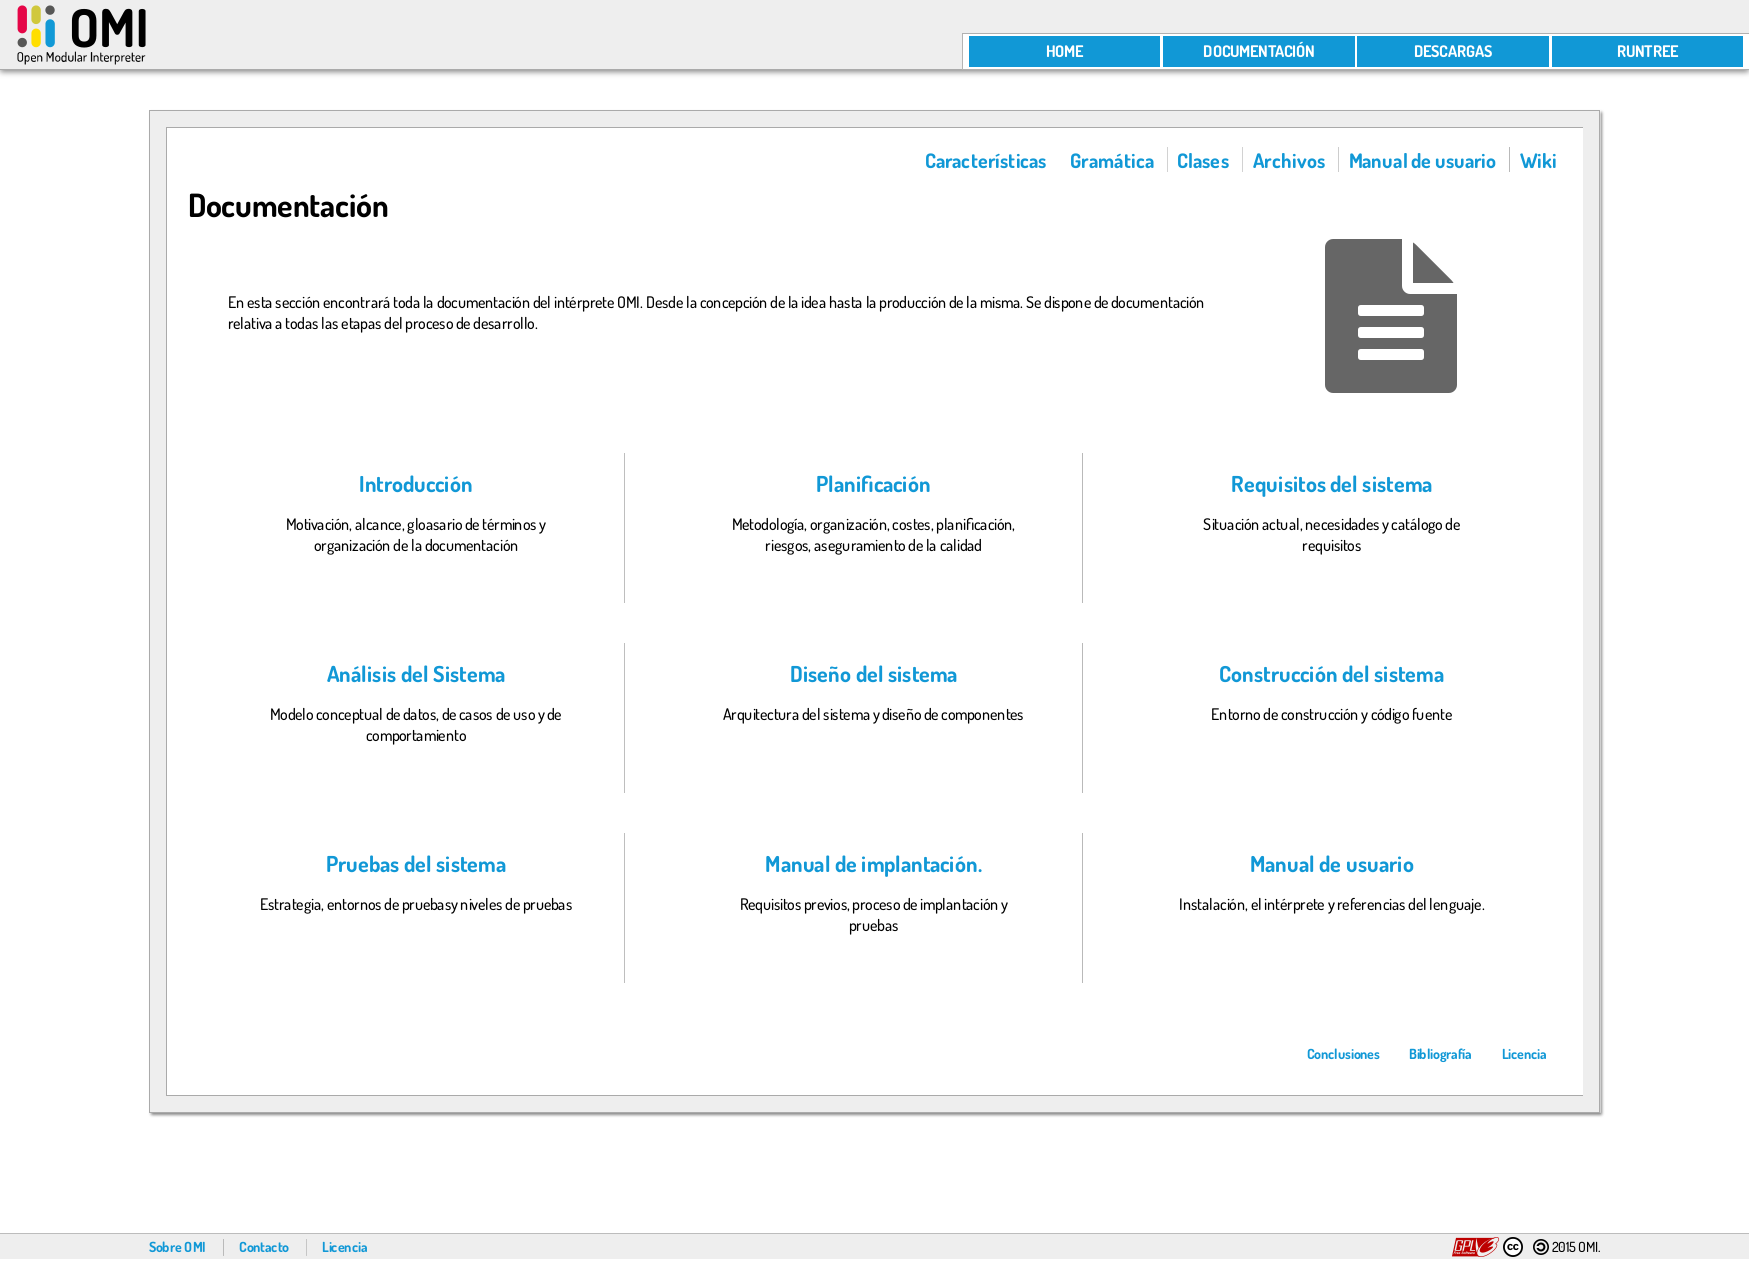
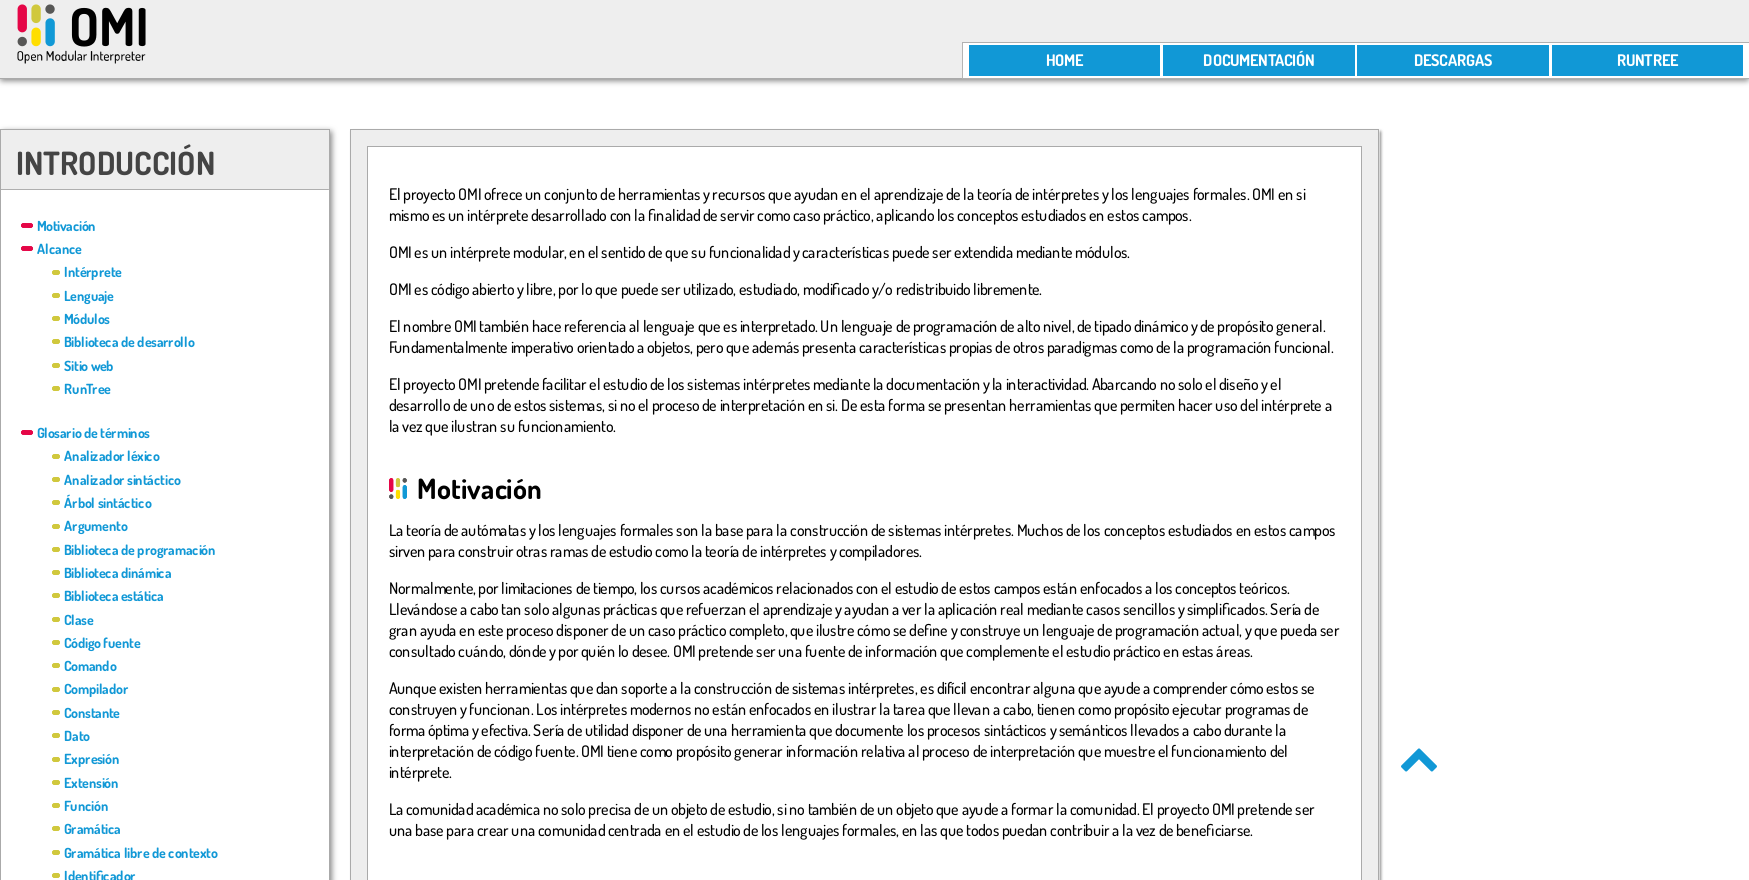
Según el análisis de la interfaz de usuario llevado a cabo se procede a detallar gráficamente cada página descrita.
Home
Sobre OMI
Contacto
Índice de la documentación
Documento
Navegador de gramática
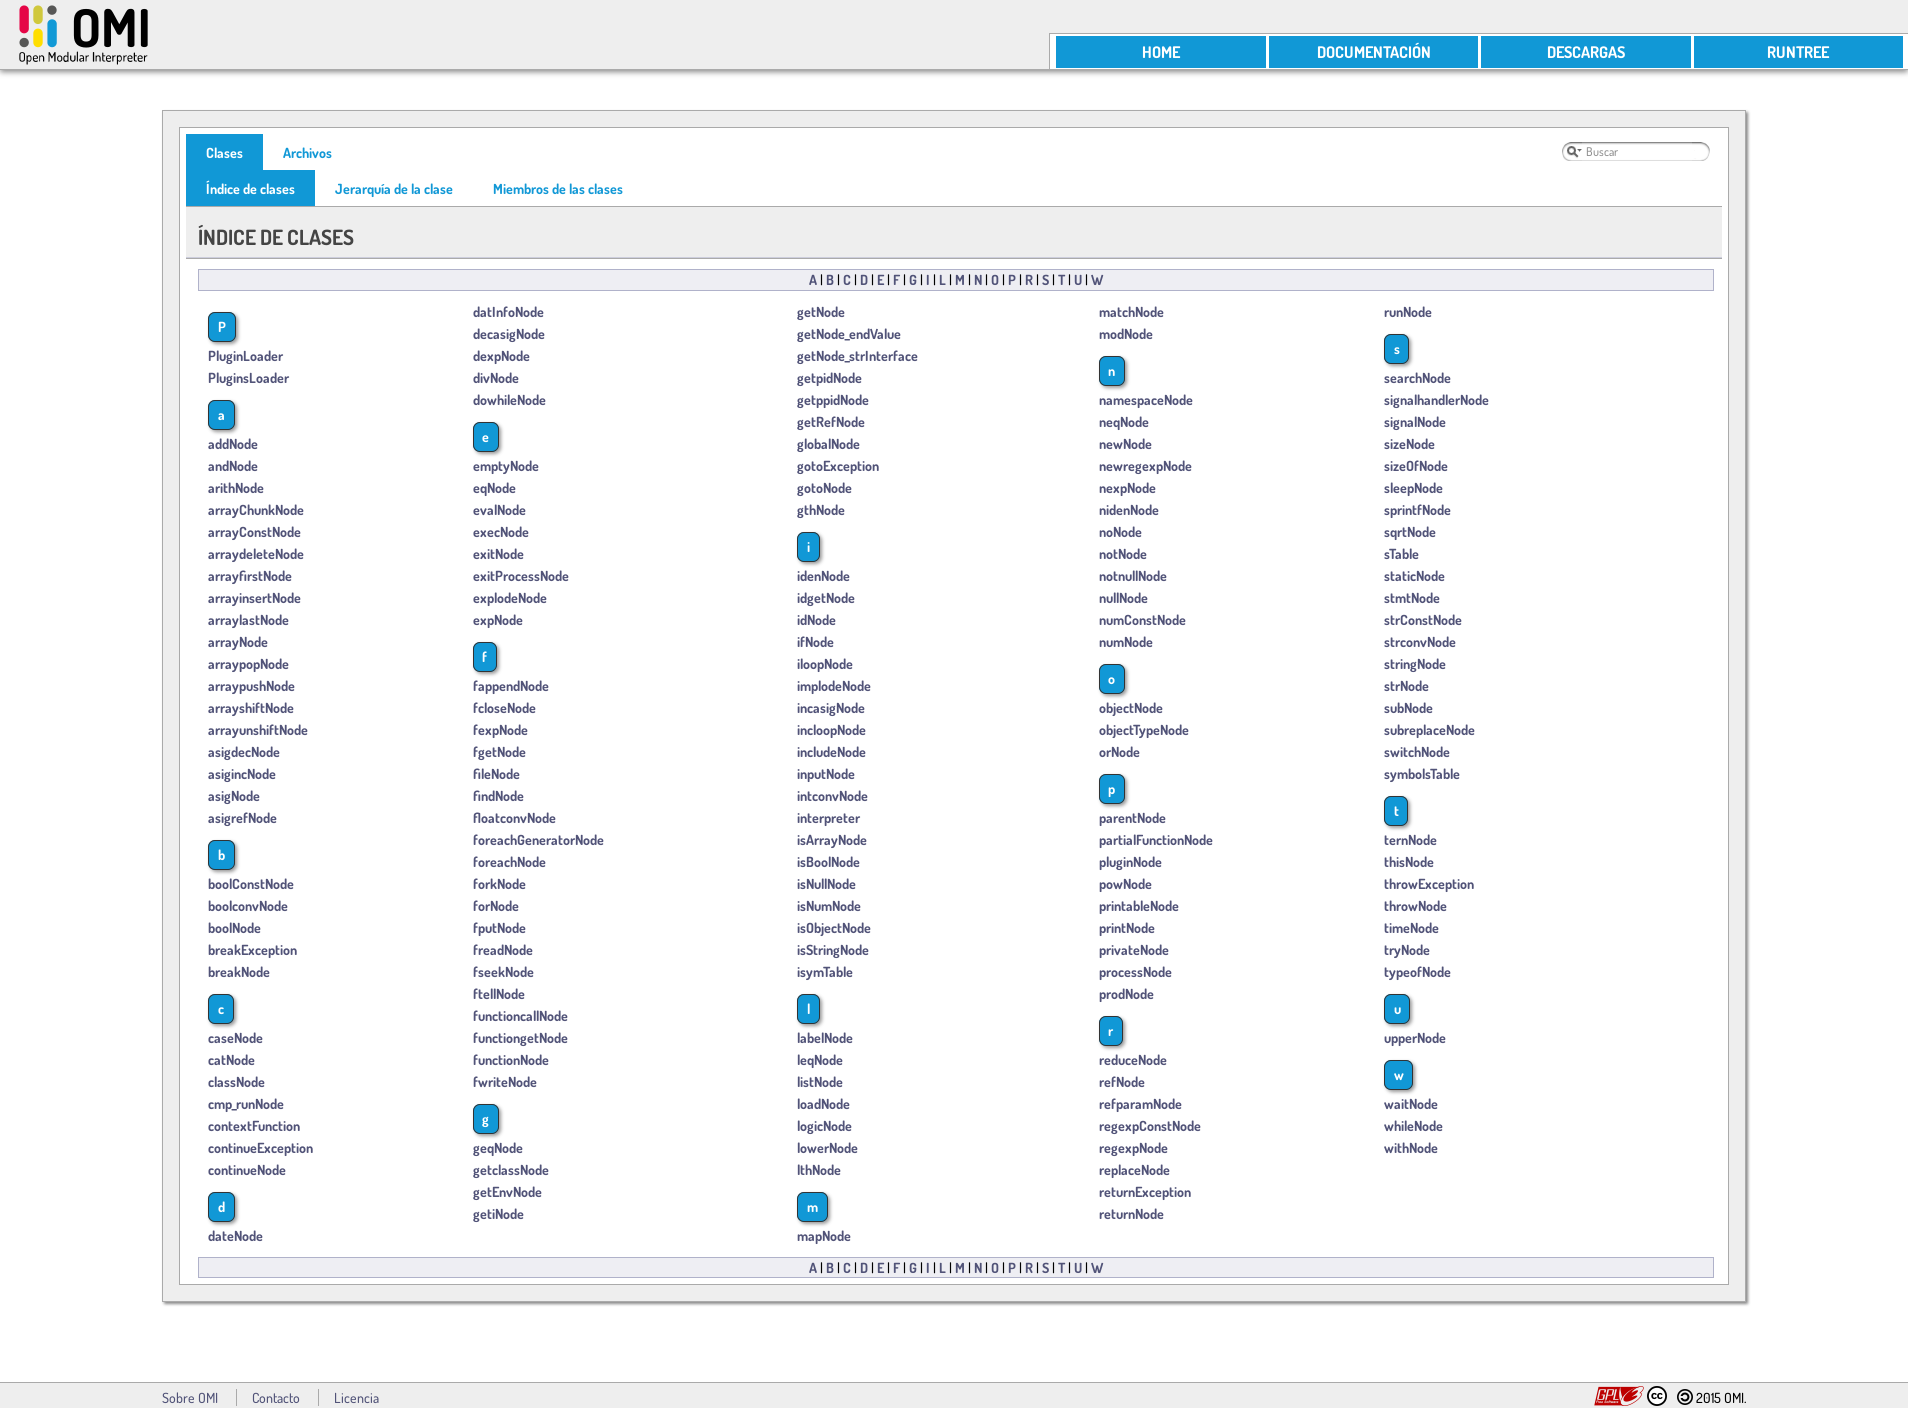
Navegador de clases
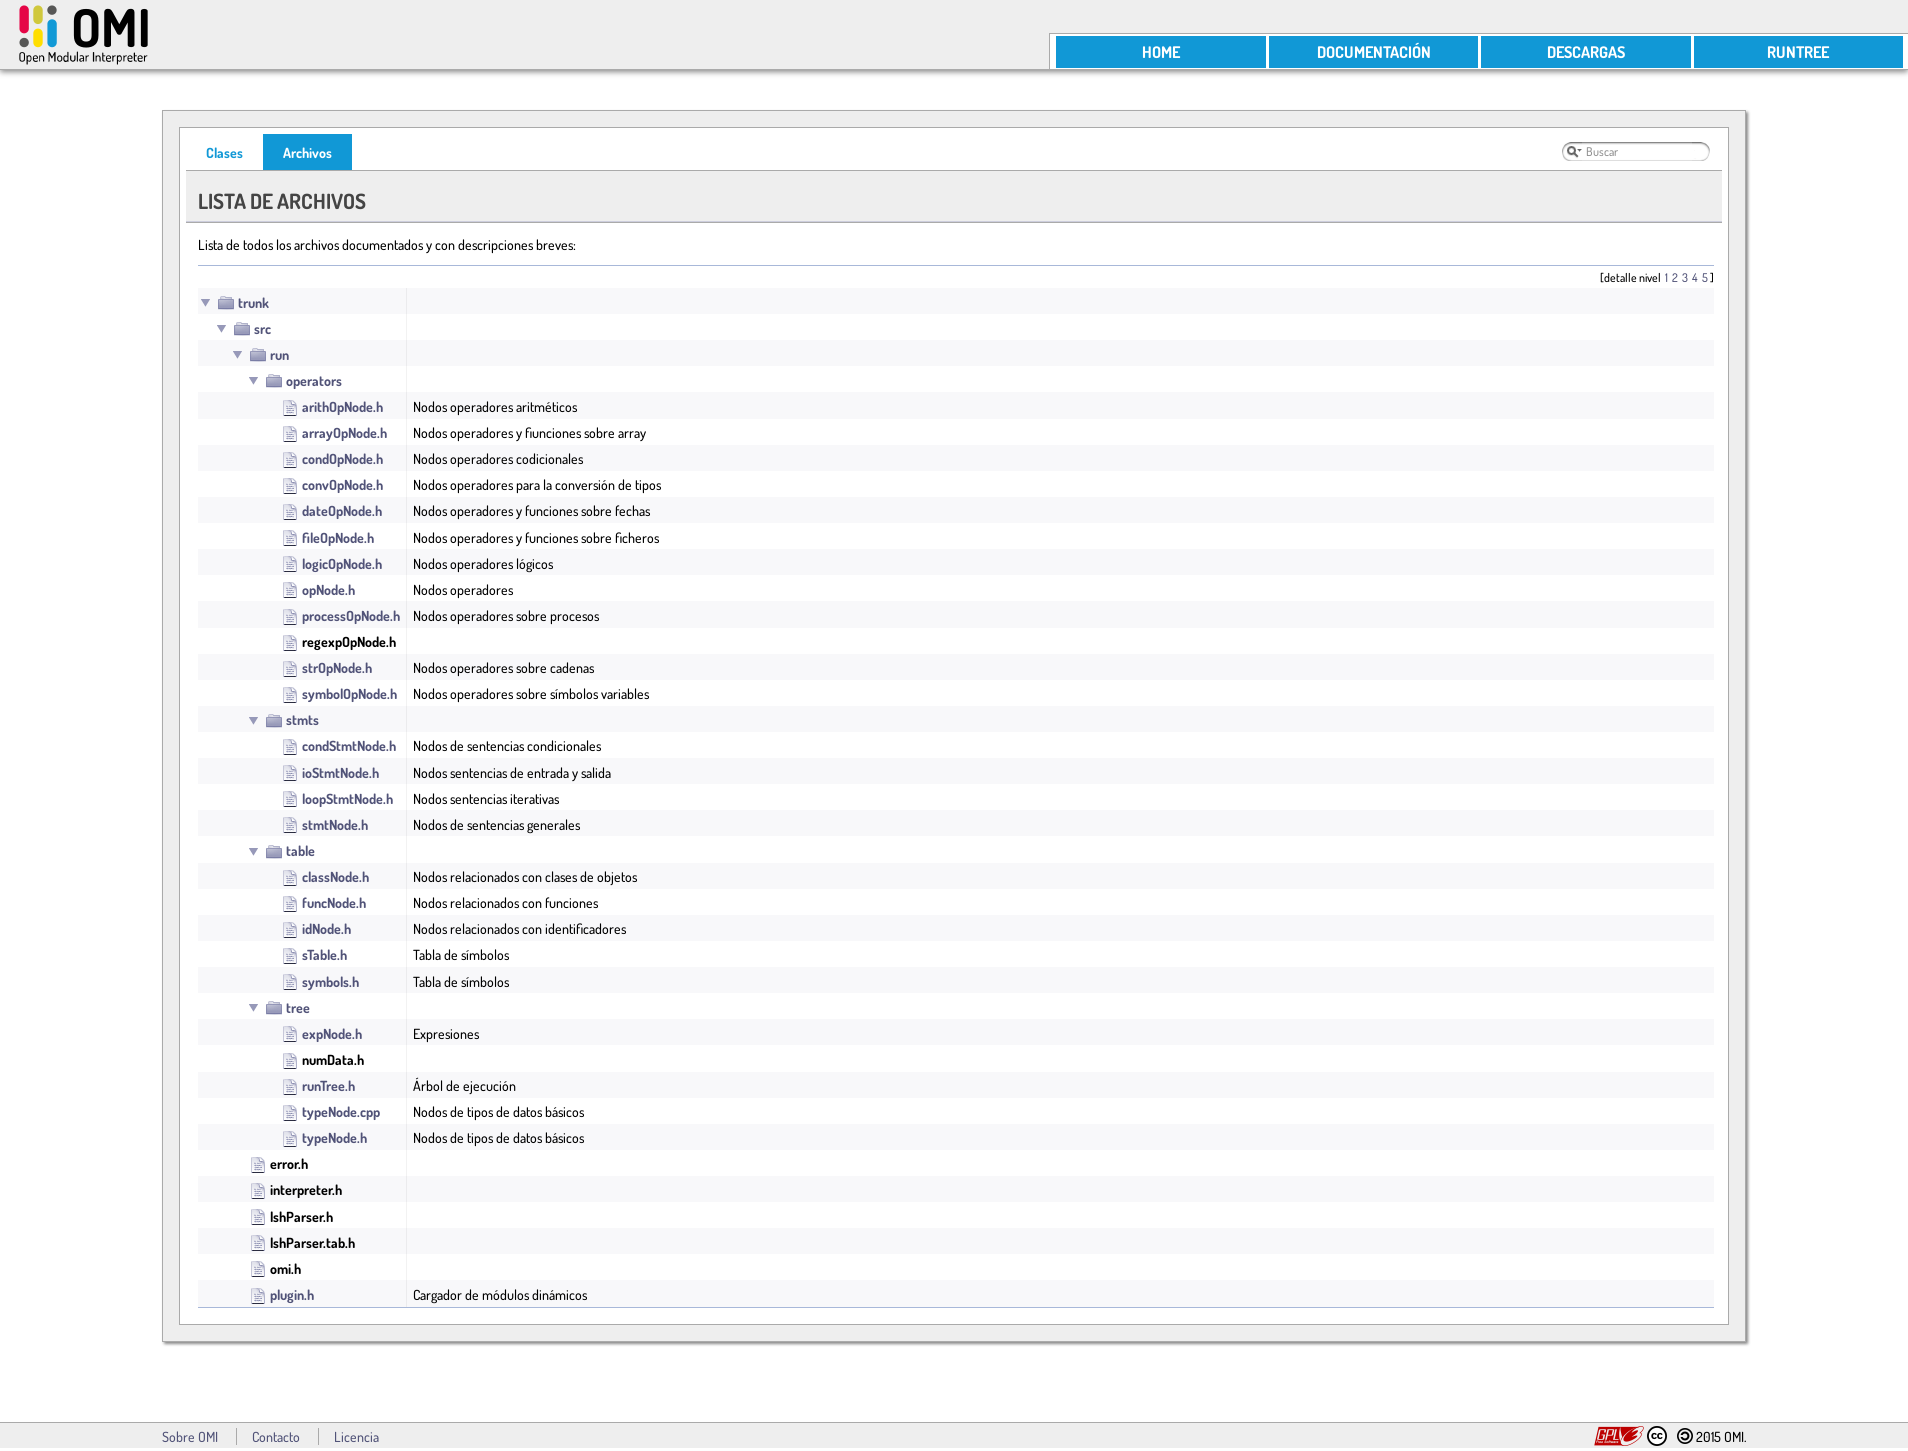
Navegador de ficheros
Descargas