
Una aplicación puede funcionar bien hoy y convertirse en un problema dentro de dos años si cada nueva función obliga a comprender medio sistema, repetir una regla en varios lugares o seguir un procedimiento de publicación que nadie sabe reconstruir.
La mantenibilidad no consiste en conseguir código perfecto. Consiste en controlar el coste y el riesgo de cambiar un sistema mientras sigue cumpliendo su función. Para lograrlo intentamos que las responsabilidades, las dependencias y las decisiones importantes permanezcan suficientemente claras a medida que el software crece.
La pregunta que guía esta página es sencilla: si mañana cambia una regla de negocio, ¿sabremos dónde modificarla, qué otras partes pueden verse afectadas y cómo comprobar que el sistema sigue funcionando?
Pregunta: ¿Qué hará difícil cambiar este software mañana?
Buscamos: responsabilidades y dependencias comprensibles.
Evitamos: complejidad que no resuelve una necesidad.
Objetivo: poder evolucionar con un coste razonable.
Ver criterios de mantenibilidad ↓
01 / El cambio revela la mantenibilidad
Una aplicación puede parecer ordenada durante meses si nadie necesita tocarla. La prueba llega cuando hay que modificar un precio, añadir un permiso, incorporar otro proveedor de pagos, actualizar una biblioteca o explicar el proyecto a una persona nueva.
Imaginemos un configurador de productos. La empresa cambia una condición comercial: cierta combinación de material y dimensiones ya no admite un descuento. La tarea parece pequeña. Pero antes de editar una línea hay que responder:
- ¿Dónde se calcula el precio: en el servidor, en el navegador o en ambos?
- ¿Esa condición se aplica también a presupuestos guardados y exportaciones?
- ¿Qué ocurre con configuraciones creadas antes del cambio?
- ¿Qué ejemplos permiten comprobar que las demás combinaciones siguen dando el resultado esperado?
La dificultad del cambio depende tanto de la regla como de cómo se haya repartido su conocimiento por el sistema. Un cambio de diez líneas puede exigir días de investigación; otro de cien líneas puede ser predecible si sus límites están claros.
La calidad del código importa cuando cambia el coste de entender, comprobar y evolucionar el software. Ése es el criterio que nos interesa, por encima de una apariencia de limpieza tomada de forma aislada.
El recorrido de un cambio
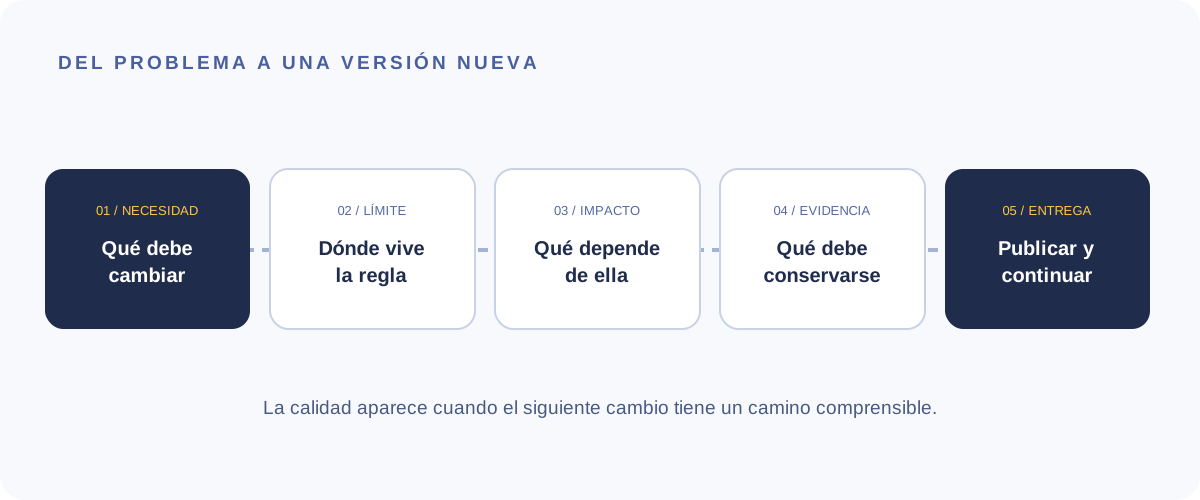
Si cada paso depende de información oculta o de modificar muchas zonas ajenas al cambio, el coste de evolución aumenta. El recorrido sirve para localizar dónde aparece la dificultad antes de decidir qué parte conviene mejorar.
02 / Calidad con consecuencias, no con gustos
Dos profesionales pueden preferir nombres, estilos o estructuras diferentes. Una diferencia de criterio no convierte automáticamente una implementación en deuda técnica.
Una característica merece atención cuando provoca una consecuencia verificable: la misma regla está representada en tres lugares, un cambio de facturación obliga a editar módulos de clientes que deberían ser independientes, o nadie puede preparar un entorno sin pedir instrucciones que no están escritas. Ahí sí podemos describir qué cuesta, qué riesgo introduce y cuándo aparece.
Tampoco es útil calificar un sistema con una nota global de «calidad». Un módulo difícil de comprender puede permanecer estable durante años, mientras una pequeña duplicación en una regla que cambia cada semana puede consumir mucho trabajo. La prioridad depende del uso y de los cambios previstos.
Esto separa esta página de la auditoría de software y deuda técnica. La auditoría examina un sistema existente para diagnosticar sus limitaciones con evidencias. Aquí explicamos los criterios que intentamos aplicar mientras diseñamos y evolucionamos software.
03 / Responsabilidades reconocibles
Una parte del sistema debería tener una razón comprensible para cambiar. Calcular un presupuesto, guardarlo, convertirlo en PDF y enviarlo por correo participan en el mismo proceso, pero responden a decisiones distintas.
Si el formato del PDF cambia, no debería ser necesario reabrir toda la lógica comercial para saber si el precio seguirá siendo correcto. Si cambia una regla de precios, tampoco debería depender de cómo se compone un correo. Mantener esas decisiones distinguibles reduce el número de cosas que hay que comprender para realizar un cambio seguro.
Eso no exige una clase por cada paso. Extraer piezas sin una responsabilidad real puede dispersar el proceso y hacerlo más difícil de seguir. Buscamos límites útiles: aquellos que nos permiten explicar dónde vive una decisión y qué información necesita de las demás.
Por ejemplo, en un motor de presupuestos, una secuencia comprensible podría ser:
Opciones elegidas
      ↓
Reglas comerciales
      ↓
Precio calculado
      ↓
Presentación, almacenamiento o envío
La secuencia no prescribe una arquitectura concreta. Hace visible que el cálculo no debería depender accidentalmente del diseño de una pantalla o del formato de un documento.
04 / Cohesión: saber dónde buscar
La cohesión describe cuánto pertenecen juntas las responsabilidades que hemos colocado en un componente. Su valor práctico aparece cuando alguien pregunta: «Ha cambiado esta regla; ¿dónde debo buscarla?».
Si parte de un cálculo de facturación vive en pedidos, otra parte en clientes y otra dentro de una plantilla visual, comprender el resultado obliga a recorrer zonas que, por separado, no explican la regla completa. Reunir el conocimiento que cambia por el mismo motivo puede hacer que el comportamiento sea más fácil de localizar y revisar.
Pero tampoco buscamos reunirlo todo en una pieza enorme. Un módulo llamado «Facturación» que calcula importes, gestiona permisos, conecta con el banco y genera informes puede contener demasiadas razones distintas para cambiar. La cohesión es una guía para encontrar un límite comprensible, no una cifra que debamos maximizar.
05 / Acoplamiento: dependencias con una razón
Los componentes necesitan colaborar. El problema no es que existan dependencias, sino que una parte tenga que conocer detalles de otra que no necesita para cumplir su función.
Supongamos que facturación necesita la dirección fiscal de un cliente. Puede pedir ese dato mediante una operación cuyo significado está claro. Si, en cambio, consulta directamente varias tablas internas, interpreta un campo heredado y replica una regla sobre qué dirección está vigente, un cambio en clientes puede obligar a modificar facturación aunque su necesidad siga siendo la misma.
Un límite explícito no elimina la dependencia: aclara de qué depende realmente el consumidor. También tiene un coste. Añadir interfaces, adaptadores o servicios para cada interacción sencilla puede producir más piezas que entender sin reducir ningún riesgo. Elegimos la separación cuando protege una decisión que razonablemente puede cambiar o que merece comprobarse por sí misma.
La arquitectura de software decide la organización global y los límites principales de un sistema. Esta página se centra en cómo esas decisiones afectan después a la capacidad cotidiana de modificarlo.
Cohesión: el conocimiento que pertenece a una responsabilidad se encuentra donde esperamos encontrarlo.
Acoplamiento: las responsabilidades distintas conocen sólo lo necesario unas de otras.
06 / El radio de un cambio
Cuando cambia una regla, observamos cuántas zonas deben editarse y por qué. Si una condición comercial aparece en el formulario, en la API, en un proceso nocturno y en una exportación, modificarla puede requerir coordinar cuatro implementaciones.
A veces esta distribución es necesaria: una aplicación presenta información de varias maneras. Lo que conviene evitar es que cada representación decida por separado la misma regla. Cuando el patrón se repite, merece la pena buscar un lugar responsable del resultado y hacer que las demás partes lo utilicen.
Un radio pequeño no significa cambiar siempre un solo archivo. Una nueva función puede requerir interfaz, datos y comunicación externa. Significa que el impacto es explicable, que las piezas afectadas están relacionadas con la necesidad y que sabemos qué revisar después.
07 / Duplicar código no siempre es duplicar conocimiento
Dos fragmentos visualmente parecidos pueden representar conceptos diferentes que evolucionarán por separado. Unificarlos sólo para eliminar líneas repetidas puede atarlos artificialmente.
Nos preocupa más la duplicación de conocimiento: varias partes del sistema deben recordar una misma regla. Si la condición de una promoción se expresa de una manera en la tienda, de otra en la API y de otra en administración, el siguiente cambio comercial exige encontrarlas todas. Aunque las tres implementaciones tengan formas distintas, comparten una decisión que debería mantenerse coherente.
Por eso no aplicamos «no repetir» mecánicamente. Antes de abstraer preguntamos si las piezas cambiarían por la misma razón. Si la respuesta es incierta, una pequeña repetición explícita puede ser más fácil de mantener que una abstracción compartida prematura.
08 / Abstracciones que ocultan una decisión útil
Una abstracción añade un nombre, un contrato y otro nivel que comprender. Merece ese coste cuando permite dejar de conocer un detalle inestable o expresa un concepto común del negocio.
Por ejemplo, una operación «obtener los datos de facturación del cliente» puede proteger a varios consumidores frente a cambios en la forma de almacenar direcciones. En cambio, crear una capa genérica que sólo reenvía cada llamada a otra capa no reduce conocimiento: lo reparte entre más archivos.
Una buena abstracción elimina conocimiento duplicado; una mala abstracción sólo desplaza la complejidad. No evaluamos su valor contando líneas ahorradas, sino observando qué cambio será más claro gracias a ella.
09 / Preparar futuros probables, no todos los imaginables
Una empresa puede saber que añadirá otra tarifa, un idioma o un proveedor externo. Conviene considerar esas evoluciones si están razonablemente definidas. Pero un «quizá algún día» no justifica por sí solo microservicios, sistemas de plugins, varias bases de datos o una configuración capaz de representar cualquier caso concebible.
Cada posibilidad incorporada por adelantado abre rutas que habrá que probar, explicar y mantener. También puede distraernos de la primera necesidad real. Intentamos dejar puntos de extensión cuando hay evidencia de que aportarán valor y posponer decisiones reversibles mientras todavía faltan datos.
No significa ignorar el futuro. Significa no cobrarle al presente el mantenimiento de un futuro hipotético.
10 / Complejidad del negocio y complejidad añadida
Algunos problemas son difíciles. Un configurador puede combinar dimensiones, materiales, cantidades, descuentos y condiciones de fabricación. Organizar bien el software no convierte en simples esas reglas que el negocio realmente necesita.
La complejidad esencial viene del problema. La accidental aparece por cómo lo implementamos: reglas duplicadas en varias interfaces, conversiones repetidas, dependencias ocultas o pasos manuales sin explicación.
La meta no es conseguir un sistema trivial ni presumir de pocas líneas de código. Es representar la dificultad real sin añadir obstáculos innecesarios para la siguiente persona que tenga que cambiarlo. La programación a medida es el servicio que construye la solución empresarial; estos criterios ayudan a que lo construido pueda seguir evolucionando.
11 / Límites con significado, no carpetas por costumbre
Una estructura con carpetas llamadas Controllers, Services y Repositories puede estar bien organizada o completamente entrelazada. Los nombres no indican por sí solos qué conocimiento puede cruzar cada límite.
Una capa tiene sentido si permite localizar una responsabilidad, controlar una dependencia, comprobar un comportamiento o sustituir una implementación sin reconstruir todo lo demás. Si sólo copia la operación de la capa anterior y añade otro archivo que abrir, puede aumentar el trabajo.
Un sistema pequeño también puede ser mantenible como una sola aplicación bien organizada. Separarlo en servicios independientes introduce contratos de red, versiones, despliegues y fallos de comunicación que sólo merecen la pena cuando existe una razón suficiente. La pregunta sigue siendo la misma que al principio: ¿este límite hará más comprensible y seguro el cambio que esperamos realizar?
12 / Contratos que permiten cambiar una implementación
Cuando dos partes del software colaboran, interesa saber qué espera una de la otra: qué operación puede solicitar, qué datos debe aportar, qué recibe y qué errores necesita contemplar. Esa expectativa es un contrato, aunque no siempre tenga la forma de una interfaz formal.
Puede expresarse mediante una API, un evento, un esquema de datos o una convención explícita dentro de la misma aplicación. Su utilidad no depende de añadir una capa por costumbre, sino de evitar que quien utiliza una función tenga que conocer detalles internos que no le pertenecen.
Volvamos a facturación. Para emitir una factura necesita datos fiscales del cliente. Si consulta directamente varias tablas de clientes e interpreta un campo heredado para averiguar qué dirección está vigente, un cambio interno en clientes puede romper facturación. Una operación con significado claro —«obtener los datos fiscales vigentes de este cliente»— concentra esa decisión donde puede explicarse y mantenerse.
El contrato debe describir también los límites: qué ocurre si el cliente no dispone de esos datos, si hay más de una dirección posible o si la información llega de otro sistema. Ocultar todos los errores tras una respuesta vacía no simplifica la colaboración; sólo aplaza la duda hasta que aparezca un fallo.
Los contratos también cambian
Si una API o un evento ya tiene consumidores, modificarlo puede afectar a equipos o versiones que no se actualizan al mismo tiempo. Antes de hacerlo preguntamos quién lo utiliza, si podemos coordinar el cambio y si hace falta un periodo de compatibilidad. Versionar puede ayudar cuando existen consumidores independientes; hacerlo con cada función interna añadiría una obligación innecesaria.
La organización global de estos límites corresponde a la arquitectura de software. Aquí nos interesa su consecuencia cotidiana: que una implementación pueda evolucionar sin obligar a sus consumidores a conocer cada detalle de ella.
13 / Datos con un responsable reconocible
Una regla no vive sólo en el código: también depende de quién puede crear o modificar la información sobre la que opera. Si varias zonas escriben directamente el mismo estado, resulta difícil saber qué condiciones deben cumplirse antes de dar una operación por válida.
En un sistema de pedidos, por ejemplo, no basta con tener un campo llamado estado. Necesitamos saber qué significa «confirmado», quién puede mover el pedido a ese estado, si exige un pago previo y qué ocurre cuando la confirmación llega dos veces. Esas preguntas describen comportamiento del negocio. Su representación concreta en tablas o servicios se decidirá según el sistema.
Los nombres ayudan cuando hacen reconocible el dominio. «Pedido», «reserva» o «regla de precio» orientan más que una colección de «gestores» y «utilidades» cuyo propósito sólo se descubre leyendo su interior. Tampoco copiamos sin pensar cualquier palabra usada en una reunión: acordamos su significado cuando diferentes personas la emplean para cosas distintas.
Estados: claridad sin maquinaria innecesaria
Cuando un estado condiciona permisos, cálculos o transiciones, representarlo explícitamente facilita comprender qué se puede hacer y qué debe impedirse. No necesita una máquina de estados formal para cada verdadero o falso. La estructura debe corresponder a la complejidad del proceso.
Esta es una frontera importante con el análisis de requisitos: allí se define qué estados y reglas necesita el negocio; aquí examinamos cómo mantenerlos localizables y modificables cuando se desarrollan.
14 / Configuración que puede explicarse y trasladarse
Una aplicación puede comportarse de la misma manera en dos entornos y necesitar, sin embargo, dominios, credenciales o direcciones de servicios distintos. Si esos valores aparecen dispersos entre el código, preparar otro entorno o cambiar un proveedor obliga a buscar y editar lugares que no deberían contener esa decisión.
Nos ayuda separar el comportamiento del producto de las condiciones del lugar donde se ejecuta. «Un pedido confirmado genera una notificación» es comportamiento; «el servidor de correo de este entorno está en esta dirección» es configuración. La distinción no exige crear un sistema genérico para cada constante, pero sí saber qué valores varían y quién los administra.
También evita que una credencial termine accidentalmente en el repositorio. Extraerla del código no resuelve por sí solo cómo se distribuye, rota o revoca; esas decisiones requieren procedimientos acordes al entorno. La seguridad de servidores aborda accesos e infraestructura, y la automatización de despliegues trata cómo llega una configuración a cada entorno cuando ese proceso necesita formalizarse.
15 / Dependencias externas con un coste visible
Utilizar librerías es normal y suele ser sensato. Rehacer internamente un problema ya resuelto también crea código que habrá que mantener. Pero cada dependencia añade una relación: versiones compatibles, condiciones de soporte, API, posibles cambios y componentes que dependen de ella.
Antes de incorporar una pieza preguntamos qué trabajo evita y qué partes de nuestro sistema conocerán su interfaz. Una librería usada en un solo punto tiene un coste de sustitución distinto al de otra cuyos tipos y convenciones atraviesan toda la aplicación. En el segundo caso puede tener sentido adaptar su modelo al nuestro o concentrar su uso tras un límite propio. Envolver automáticamente cualquier paquete en una interfaz añade archivos sin garantizar flexibilidad.
Las dependencias indirectas también cuentan. Una librería puede introducir otras que no hemos elegido expresamente. Si aparece una incompatibilidad o un problema de seguridad en una de ellas, necesitamos saber qué paquete la incorpora y qué opciones de actualización existen. Esta página se detiene en el efecto sobre la evolución del software; la evaluación de una vulnerabilidad concreta necesita su propio alcance de seguridad.
Cuando la dependencia es un servicio externo —un ERP, una pasarela o una API— importa además quién es responsable de cada dato y qué ocurre si la respuesta falla o cambia. La implementación de esas conexiones pertenece a integración de sistemas y APIs. Aquí explicamos por qué conviene que su presencia no quede escondida entre reglas ajenas.
16 / Actualizar con criterio, no por reflejo
Una versión nueva no es una mejora automática para cualquier proyecto. Puede resolver un problema importante, pero también exigir cambios incompatibles que aún no aportan valor. Del mismo modo, posponer todas las actualizaciones durante años puede convertir una revisión sencilla en una migración difícil.
Distinguimos tres motivos: necesidad por seguridad, fin de soporte o incompatibilidad; utilidad porque una versión elimina una limitación real; y opción cuando el beneficio actual no compensa el trabajo. Esa clasificación obliga a conocer qué versiones usamos, qué depende de ellas y cómo comprobaremos que la aplicación sigue cumpliendo sus funciones después del cambio.
No perseguimos «la última versión» como objetivo independiente. Buscamos una base que podamos sostener y evolucionar con un coste razonable.
17 / Errores que dejan un estado comprensible
Una operación puede fallar aunque su código sea claro. La cuestión para mantenerla es si podemos responder qué parte llegó a ejecutarse, qué información quedó guardada y qué puede hacerse a continuación.
Supongamos que una compra crea un pedido, solicita el cobro y envía una confirmación. Si falla el último paso, no queremos tratar el caso como si nada hubiera ocurrido ni cobrar de nuevo al repetir la operación. Hay que distinguir el resultado comercial del pedido, el estado del cobro y el estado de la notificación. Según el proceso, la solución puede incluir una transacción, un estado pendiente, un reintento controlado o una operación compensatoria. Ninguna de esas técnicas se impone por defecto; primero definimos qué resultado sería correcto.
Capturar cualquier error y continuar silenciosamente puede convertir un fallo visible en datos incoherentes difíciles de investigar. Mostrar al usuario una excepción interna completa tampoco le ayuda a actuar y puede exponer detalles que no necesita. Separamos la información técnica útil para el diagnóstico, el significado del fallo dentro del proceso y la respuesta que necesita la persona afectada.
18 / Diagnóstico sin registrar todo
Cuando aparece una incidencia, mantener el software exige comprender qué hizo. Un registro útil permite relacionar una operación con su estado, el componente que intervino y el punto de fallo. En una integración puede ser importante saber qué solicitud se intentó, si hubo respuesta y si se produjo un reintento.
Eso no equivale a guardar indiscriminadamente datos personales, credenciales o documentos completos. El contexto registrado debe ser suficiente para investigar y proporcionado a la sensibilidad de la información. Un identificador de operación puede unir eventos sin copiar todo su contenido en cada línea.
La monitorización de servidores es la especialidad que trata métricas, avisos y observación operativa continuada. Aquí el punto es más acotado: un comportamiento que no deja rastro comprensible cuesta más de corregir y evolucionar.
19 / Pruebas que protegen el comportamiento
Cuando modificamos una regla, necesitamos saber qué debía seguir funcionando. Las pruebas aportan una forma de comprobarlo sin depender sólo de recordar todos los recorridos posibles o de repetir manualmente una visita a la aplicación.
Imaginemos una tarifa que distingue entre reserva individual y grupo. Si cambia el umbral de participantes, una prueba puede mostrar tanto el nuevo cálculo como los casos que no debían cambiar: una reserva anterior, un descuento incompatible o un importe mínimo. El valor no está en contar pruebas, sino en detectar una consecuencia no deseada antes de entregarla.
No todo comportamiento requiere la misma comprobación. Una regla aislada puede verificarse con una prueba pequeña; una reserva que atraviesa pago y confirmación necesita comprobar también la colaboración entre componentes; y una acción visible puede requerir una revisión en el navegador. Elegimos el nivel según el riesgo y la clase de error que queremos descubrir. La estrategia completa de testing tendrá su propia página; aquí nos interesa su relación con la capacidad de cambiar el sistema.
Una red de seguridad no elimina el juicio
Una prueba que confirma exactamente la implementación actual puede fallar ante cualquier reorganización interna, aunque el usuario reciba el mismo resultado. Otra puede pasar mientras una integración real está rota. Por eso conviene formular las comprobaciones alrededor de comportamientos observables y reservar las verificaciones de detalle para aquellos casos en que el detalle sea realmente un contrato.
Las pruebas no prometen ausencia de errores. Reducen la incertidumbre sobre partes concretas y permiten explicar qué se ha comprobado al modificar una pieza.
20 / Testabilidad: poder observar lo que cambia
Si para comprobar una regla de precios hay que iniciar toda la aplicación, conectar servicios externos y preparar una base de datos completa, probablemente esa regla depende de más cosas de las que necesita. Separar el cálculo de la obtención de datos permite observarlo con entradas y resultados claros.
La testabilidad no exige dividir cada línea en una clase ni introducir interfaces artificiales. Significa que los efectos importantes pueden prepararse, ejecutarse y comprobarse sin reconstruir una cadena desproporcionada. Cuando intervienen el tiempo, el azar o un proveedor externo, conviene saber cómo controlar esas condiciones durante una comprobación sin falsear el funcionamiento real.
También es una señal de diseño. Si nadie puede explicar qué dato provoca un resultado o qué efecto ha producido una operación, el problema afecta tanto a las pruebas como al mantenimiento futuro.
21 / Refactorizar sin cambiar lo que recibe el usuario
Refactorizar es modificar la estructura interna para facilitar el trabajo posterior mientras se conserva el comportamiento esperado. Puede consistir en dar nombre a una regla dispersa, separar una responsabilidad o sustituir una dependencia difícil de controlar. No es sinónimo de reescribir toda la aplicación ni una garantía de mejora por el mero hecho de mover código.
Antes de tocar una parte delicada necesitamos identificar sus entradas, salidas y efectos relevantes. Después realizamos un cambio de alcance comprensible y comprobamos que el comportamiento acordado continúa. En una zona sin pruebas ni documentación, ese primer paso puede requerir observación y pequeñas comprobaciones de caracterización: registrar lo que efectivamente hace el sistema antes de intentar ordenarlo.
Aprovechar una modificación sin ampliarla sin límite
Una petición funcional puede revelar que la misma regla aparece en tres lugares. Tiene sentido ordenar esa zona si hacerlo reduce el riesgo del cambio actual. En cambio, aprovechar una corrección menor para reorganizar módulos que no intervienen dificulta revisar qué ha cambiado y atribuir el origen de un fallo.
La pregunta práctica es: ¿qué mejora estructural hace más segura esta modificación y hasta dónde podemos verificarla? Ese límite ayuda a que la refactorización siga siendo una inversión controlada.
22 / Deuda técnica: el coste de una decisión pendiente
No todo código antiguo constituye deuda técnica. Tampoco toda solución provisional es un error: a veces permite aprender antes de asumir una inversión mayor. La deuda aparece cuando una decisión que facilitó una entrega sigue imponiendo un coste o un riesgo a los cambios siguientes y no existe un plan claro para afrontarla.
Por ejemplo, una regla comercial copiada en el formulario, el cálculo del pedido y una exportación puede funcionar hoy. Cuando cambia la regla, hay que localizar las tres versiones y comprobar que ninguna queda atrás. El coste empieza a repetirse. La prioridad de corregirla aumenta si esa regla cambia con frecuencia o si una discrepancia afecta a importes cobrados; disminuye si el flujo va a retirarse pronto y apenas se modifica.
Por eso priorizamos con preguntas concretas: ¿qué cambio próximo bloquea?, ¿cuánto trabajo repetido causa?, ¿qué daño puede producir un fallo?, ¿qué evidencia tenemos y qué costaría reducir el problema? Una cifra global de «deuda» sin relación con decisiones reales rara vez indica por dónde empezar.
Cuando una empresa necesita conocer el estado de un sistema heredado antes de decidir inversiones, corresponde una auditoría de software y deuda técnica. Esta página trata qué hacer con esas decisiones durante la evolución cotidiana; no sustituye el diagnóstico de un producto concreto.
23 / Software heredado: comprender antes de ordenar
Un sistema puede llevar años resolviendo operaciones que nadie ha descrito por completo. Algunas conductas parecerán extrañas en el código y, aun así, pueden sostener acuerdos con clientes, formatos de un proveedor o excepciones del negocio. Eliminarlas por parecer inconsistentes puede causar un problema mayor que el que queríamos corregir.
Empezamos por acotar la zona que debe cambiar: quién la usa, qué datos toca, qué resultados produce y qué otros componentes dependen de ella. Las incidencias, ejemplos de entrada y salida, registros y personas que operan el sistema pueden ayudar a reconstruir su comportamiento. No necesitamos entender todo el producto para realizar una modificación pequeña, pero sí aquello que nuestra modificación puede alcanzar.
Cuando es posible, añadimos comprobaciones que capturen ese comportamiento antes de cambiarlo. Son una descripción provisional de lo observado, no una afirmación de que cada resultado histórico sea correcto. Si descubrimos un defecto, lo separamos de la reorganización para decidir explícitamente si debe conservarse por compatibilidad, corregirse o migrarse.
24 / Cuándo plantear una reescritura
La frustración con un código difícil no basta para justificar empezar de cero. Una reescritura debe volver a descubrir reglas, datos, excepciones, integraciones y hábitos que el sistema anterior acumuló. También exige mantener la actividad mientras se construye el reemplazo.
Puede tener sentido si la base impide cambios indispensables, si una dependencia llega a un límite sin salida razonable o si el modelo actual ya no representa el negocio. Aun así, conviene comparar alternativas de menor alcance: sustituir una integración, extraer una función, migrar un módulo o retirar una parte que ya no se usa.
La decisión pertenece a la arquitectura de software y, si el estado de partida es incierto, puede necesitar antes una auditoría. Nuestra regla de mantenibilidad es más simple: no confundimos el atractivo de una base nueva con la evidencia de que la sustitución completa sea la opción más segura.
25 / Documentación que ahorra preguntas reales
La documentación útil responde a dudas que el código, por sí solo, no resuelve con facilidad. ¿Cómo se prepara el entorno? ¿Qué servicio externo debe estar disponible? ¿Qué significa un estado del pedido? ¿Dónde se decide un precio? ¿Qué operación permite recuperar un proceso interrumpido?
No buscamos describir cada archivo o copiar el nombre de cada función en otro lugar. Esa documentación envejece deprisa y obliga a mantener dos versiones de la misma información. Preferimos explicar los límites del sistema, los flujos delicados, las dependencias externas y los procedimientos que otra persona necesitaría ejecutar.
También importa mantenerla cerca del cambio. Si se modifica un contrato público o la forma de desplegar, la explicación correspondiente debe revisarse en la misma intervención. Una guía perfecta el día de la entrega, pero falsa seis meses después, puede ser peor que una guía breve y comprobable.
Comentarios para explicar el porqué
Un comentario que repite «sumar el total» junto a una suma no aporta contexto. En cambio, puede ser decisivo explicar por qué una excepción fiscal se calcula de otra manera, a qué versión antigua responde una compatibilidad o qué restricción impuso una API externa. Si esa razón deja de aplicarse, el comentario también debe cambiar.
26 / Registrar decisiones que condicionan el futuro
Algunas decisiones no pueden deducirse mirando el resultado. Puede parecer que una integración usa un archivo diario por comodidad, cuando en realidad el proveedor no ofrece una API fiable. Si esa razón desaparece, alguien debería poder reconsiderar la solución sin tener que adivinar la historia.
Para decisiones con consecuencias duraderas conviene dejar constancia del contexto, las alternativas razonables, el motivo de la elección y las condiciones que harían revisarla. Puede ser una nota breve en el repositorio; no hace falta implantar un formato solemne para cada detalle. Lo importante es conservar la razón junto a la solución.
Esta práctica complementa la consultoría de arquitectura de software: la arquitectura decide límites y compromisos; el registro evita que se pierda el criterio cuando cambian las personas o las circunstancias.
27 / Consistencia que deja ver las diferencias importantes
Si cada módulo nombra los mismos conceptos de manera distinta, organiza los errores a su manera y sitúa las reglas en lugares imprevisibles, una persona debe aprender un pequeño sistema nuevo cada vez que cambia de zona. Unas convenciones compartidas reducen ese esfuerzo.
La consistencia no exige imponer una forma única para problemas diferentes. Una importación de datos y una pantalla de consulta pueden necesitar estructuras distintas. Se trata de que las excepciones sean intencionadas y explicables, mientras lo rutinario sigue un patrón reconocible.
Las herramientas automáticas ayudan con formato, errores evidentes y ciertas reglas acordadas. Dejan de ser útiles si obligan a debatir cada aviso irrelevante o si sustituyen la revisión del comportamiento. Automatizamos lo mecánico para dedicar la atención humana a las decisiones que afectan al producto.
28 / Revisar cambios con contexto
Cuando intervienen varias personas, revisar un cambio puede detectar supuestos que su autor no vio: una regla duplicada, una incompatibilidad con otro flujo o una explicación que faltará al siguiente desarrollador. Una revisión útil pregunta qué necesidad resuelve el cambio, qué partes toca y cómo se ha comprobado.
Para eso el tamaño importa. Un cambio que mezcla una función nueva, una actualización general de dependencias y una reorganización completa es más difícil de entender que intervenciones separadas con propósito claro. Separar no siempre será posible, pero conviene hacer visible qué piezas están relacionadas y por qué.
La revisión entre compañeros depende del equipo y del alcance; no la presentamos como un ritual universal de dev2bit. Incluso en un proyecto llevado por una sola persona, preparar el cambio para que sea legible después —por el cliente o por otro profesional— mejora la continuidad.
29 / Un historial que permita reconstruir qué ocurrió
El control de versiones conserva código, pero su utilidad para mantenerlo depende también de cómo se registran los cambios. Un historial con intervenciones identificables permite localizar cuándo apareció una regla, qué se intentó corregir y qué partes se modificaron juntas.
Una descripción breve del motivo suele valer más que un mensaje genérico como «ajustes». Si un cambio tiene efectos delicados, conviene que la referencia a la incidencia o la decisión quede accesible. La intención no es convertir cada confirmación en un informe, sino evitar que el motivo desaparezca en cuanto se entrega.
El repositorio, sus accesos y la forma de transferirlo deben quedar claros en cada proyecto. La continuidad no depende sólo de que el código exista: otra persona necesitará saber qué versión está publicada, cómo preparar el entorno y dónde encontrar las decisiones que no son visibles a primera vista.
30 / Un entorno que otra persona pueda preparar
El repositorio no basta si para poner en marcha la aplicación hay que descubrir de memoria qué versión del lenguaje se usó, qué servicios deben arrancar y qué orden siguen los pasos de instalación. Una persona nueva necesita una ruta comprobable desde el código hasta una aplicación que funcione en un entorno de trabajo.
Esa ruta puede describir versiones y extensiones necesarias, dependencias, base de datos, procesos de compilación y datos de ejemplo apropiados. También debe distinguir lo que se puede preparar localmente de aquello que sólo existe en un entorno del cliente. Si una integración externa no puede usarse fuera de producción, conviene explicarlo y ofrecer una forma razonable de trabajar sobre la parte que sí podemos comprobar.
Un contenedor puede reducir diferencias entre equipos, pero no vuelve reproducible un proyecto por sí mismo. Si sus imágenes no están identificadas, el arranque exige secretos desconocidos o los datos iniciales dependen de una copia manual, la dificultad sigue ahí. Cuando la cuestión es la operación de contenedores como infraestructura, corresponde al servicio de Docker y contenedores.
Conocer las variables sin exponer las credenciales
Documentar que una integración necesita una clave, quién la proporciona y dónde se configura ayuda a continuar el proyecto. Guardar el valor real en la documentación o en el repositorio puede comprometerlo. La descripción del entorno debe hacer visible la dependencia sin convertir el secreto en conocimiento compartido innecesariamente.
31 / Los datos también evolucionan
Cambiar código es sólo una parte de la modificación. Si aparece un nuevo estado de pedido o se separan dos tipos de cliente, los datos ya guardados deben seguir teniendo significado. Una migración expresa cómo pasa una estructura a la siguiente, pero su existencia no garantiza que el cambio sea seguro.
Antes de aplicarla preguntamos cuántos datos afecta, qué ocurrirá con los registros anteriores, cuánto puede durar y qué versión de la aplicación podrá leerlos durante la transición. Añadir una columna opcional suele ser distinto de reinterpretar importes históricos. Algunas transformaciones pueden revertirse; otras necesitan una copia recuperable y un plan de corrección porque perder información no se arregla ejecutando el cambio al revés.
Si dos versiones de la aplicación convivirán durante una publicación gradual, quizá ambas deban entender temporalmente el dato antiguo y el nuevo. Esa compatibilidad añade trabajo, pero puede evitar que una entrega parcial deje el sistema inutilizable. La automatización de despliegues trata el procedimiento para entregar versiones; aquí nos interesa que el modelo de datos pueda atravesar ese procedimiento sin perder su coherencia.
32 / Corregir seguridad sin atravesar medio sistema
La mantenibilidad tiene una consecuencia de seguridad muy concreta: cuando aparece una dependencia vulnerable, una credencial debe cambiar o un permiso resulta excesivo, necesitamos saber dónde intervenir y cómo comprobar el efecto. Si la misma decisión está dispersa por muchas zonas, aplicar la corrección cuesta más y aumenta el riesgo de dejar una copia atrás.
Eso no convierte la calidad interna en una garantía de seguridad. Una base de código comprensible también puede contener fallos graves. La protección de accesos, servidores y configuración tiene su propio alcance en seguridad y hardening de servidores. En esta hoja nos detenemos en una condición previa útil: que las partes relevantes sean localizables y modificables cuando haya que actuar.
33 / Poder operar también forma parte de poder mantener
Una aplicación no está resuelta porque compile. Tras la entrega alguien tendrá que publicar cambios, detectar fallos, actualizar dependencias y recuperar el servicio si ocurre una incidencia. Esas tareas pueden pertenecer a personas distintas de quienes escriben el código, pero necesitan instrucciones y responsabilidades conocidas.
Por ejemplo, si una actualización falla después de modificar la base de datos, el equipo debe saber qué versión se estaba ejecutando, qué pasos llegaron a completarse y cómo se recuperará una situación consistente. No hace falta que cada proyecto tenga una plataforma compleja de operación. Sí hace falta que las acciones críticas no dependan de improvisar en producción.
El detalle de las herramientas corresponde a sus especialidades: automatización de despliegues, monitorización y copias de seguridad y recuperación. Su relación con esta página es que un cambio sólo queda realmente controlado cuando podemos entregarlo y, si hace falta, recuperarnos de él.
34 / Continuidad cuando cambian las personas
Puede incorporarse un desarrollador, cambiar el responsable interno del cliente o asumir otro proveedor el mantenimiento. Un sistema complejo tendrá siempre una curva de aprendizaje. La meta no es eliminarla, sino evitar que el conocimiento imprescindible sólo exista en la cabeza de una persona.
La continuidad puede comprobarse con un recorrido concreto:
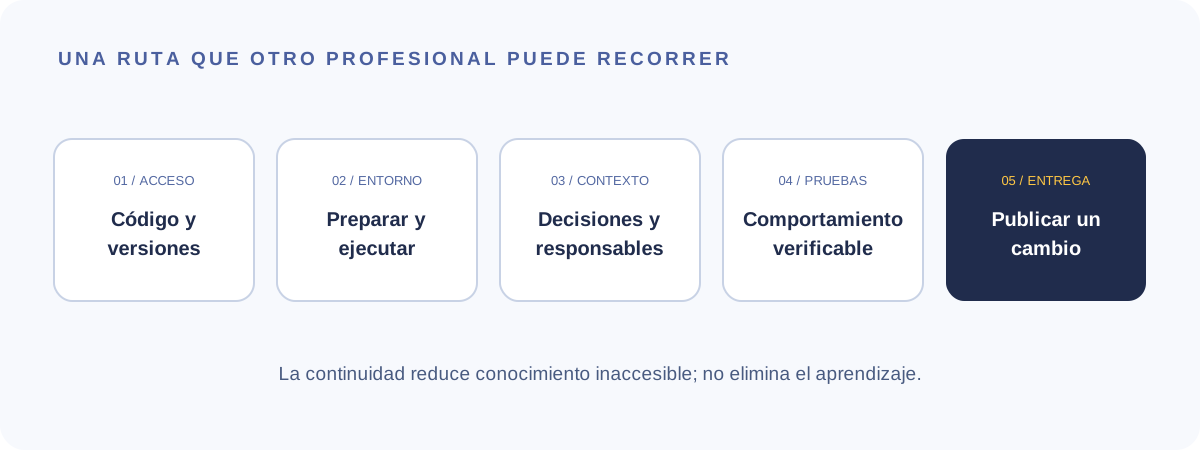
Cada flecha revela una posible dependencia. Disponer del código sin acceso a la configuración necesaria no permite ejecutarlo. Tener pruebas sin saber cuáles son fiables tampoco ayuda mucho. Documentar la arquitectura sin indicar cómo se publica deja incompleto el último paso.
Si una operación sólo puede realizarla una persona porque nadie más tiene acceso o sabe cómo se hace, existe una dependencia organizativa además de técnica. Su solución puede requerir acordar custodias y procedimientos con el cliente, no únicamente editar código. Las condiciones de repositorio, licencias, infraestructura y entrega se definen en cada proyecto de programación a medida; la mantenibilidad explica por qué esos acuerdos afectan a su vida posterior.
Una buena transferencia no promete que otro profesional entienda el sistema en una tarde. Le permite comenzar sin reconstruir información deliberadamente retenida.
35 / El tiempo de incorporación también cuesta
La primera tarea de una persona nueva no suele ser programar: es construir un mapa mental del producto. ¿Dónde entra un pedido? ¿Qué componente decide su precio? ¿Qué datos son propios y cuáles llegan del ERP? ¿Qué prueba muestra el recorrido principal?
Los nombres del dominio, una estructura coherente, ejemplos de flujos, un entorno preparable y un historial legible acortan esa investigación. Un pequeño recorrido guiado por un cambio reciente puede valer más que cien páginas de documentación sin relación con el trabajo real. También ayuda distinguir lo que sabemos de lo que aún está por averiguar; fingir certeza sobre un comportamiento heredado sólo retrasa el problema.
No documentamos todo para un lector hipotético. Conservamos las pistas necesarias para que el siguiente profesional pueda formular mejores preguntas y localizar respuestas verificables.
36 / La solución adecuada depende del proyecto
Una herramienta interna que utilizan cinco personas y una plataforma de la que dependen varios equipos no necesitan idéntica inversión en entornos, automatización, tolerancia a fallos o documentación. Las dos pueden estar bien diseñadas si sus decisiones responden a sus riesgos reales.
Para decidir cuánto estructura añadir consideramos la frecuencia de cambio, la vida prevista del producto, el daño de un fallo, las integraciones, el tamaño del equipo y el coste de operar la solución. La complejidad del negocio puede justificar reglas complejas; eso no justifica complejidad adicional que nadie necesita.
Una arquitectura muy distribuida, un sistema configurable para cualquier caso imaginable o una documentación exhaustiva tienen costes propios. La calidad no consiste en maximizar todos los atributos a la vez. Consiste en elegir qué propiedades permiten a este software cumplir su función y seguir cambiando a un coste asumible.
37 / Medir para decidir dónde mirar
El número de líneas, la cobertura de pruebas, la duplicación o la complejidad de una función pueden señalar zonas que merecen una revisión. Ninguna cifra responde por sí sola si el diseño es adecuado. Una función larga puede expresar una regla difícil pero estable; diez funciones cortas pueden ocultar un recorrido que nadie consigue seguir.
Nos interesa especialmente la combinación de cambios frecuentes y cambios difíciles. Si cada modificación en el cálculo de tarifas obliga a investigar varias capas y corregir incidencias posteriores, mejorar esa zona puede recuperar su coste pronto. Una pieza compleja que lleva años estable puede tener menos prioridad, salvo que su riesgo de fallo sea alto.
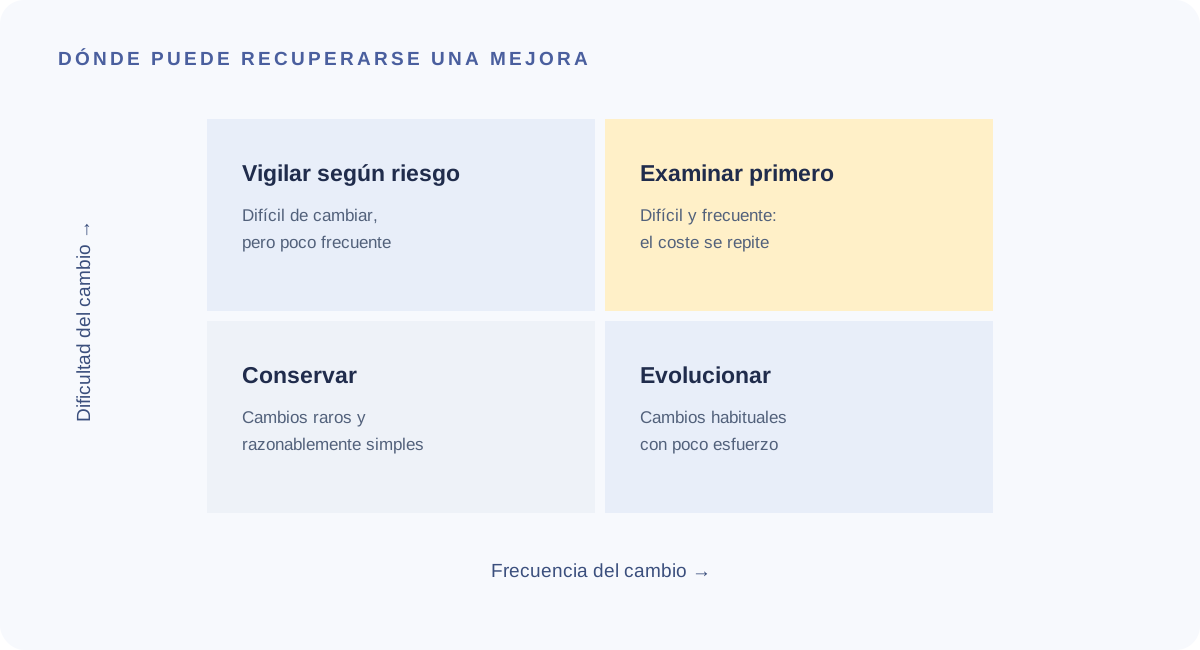
Es una guía para preguntar por trabajo y riesgo reales, no una puntuación automática del código. Antes de intervenir también comprobamos si la dificultad proviene de requisitos ambiguos, datos inconsistentes o dependencias externas: reorganizar clases no arregla por sí solo esos problemas.
38 / Tres proyectos, tres razones para pensar en continuidad
Los ejemplos siguientes ilustran tipos distintos de evolución. Sus fichas describen trabajo realizado; no los utilizamos para afirmar que todos compartan una arquitectura, una métrica de calidad o una práctica interna concreta.
W2C: reglas comerciales junto a una experiencia visual
W2C permite componer letras corpóreas en un editor y calcular presupuestos según medidas, materiales y otras condiciones. La ficha documenta un editor, un plugin de administración y un motor de reglas. El caso muestra por qué, cuando se modifica una condición de precio, importa distinguir qué decide el cálculo y qué muestra la interfaz. Es una necesidad de mantenibilidad que nace del propio producto, no de seguir un patrón por moda.
Renovatio: un dominio empresarial que evoluciona durante años
El ERP de Renovatio relaciona expedientes, operarios, documentos y funciones económicas para coordinar reparaciones y siniestros. Es un ejemplo de software donde nuevas reglas y procesos deben convivir con información anterior. La continuidad exige comprender qué significa cada estado y qué otras operaciones dependen de él antes de alterarlo. Su ficha documenta además años de acompañamiento técnico, sin que eso permita atribuir a cada módulo una técnica concreta que no se haya publicado.
Cuaderno Amarillo: intervenir en un sistema que ya existía
En Cuaderno Amarillo desarrollamos la web corporativa e hicimos arreglos e intervenciones sobre una plataforma de cursos a medida heredada. El caso demuestra una situación habitual: aportar cambios útiles a código existente sin presuponer que la única salida sea sustituir toda la aplicación. No lo presentamos como una auditoría integral de esa plataforma.
39 / Qué buscamos al diseñar software mantenible
Podemos condensar esta hoja en ocho preguntas para un cambio futuro:
| Criterio | Pregunta práctica |
|---|---|
| Responsabilidades localizables | ¿Sabemos dónde debería vivir la nueva regla? |
| Dependencias visibles | ¿Sabemos qué partes y proveedores puede afectar? |
| Cambio acotado | ¿Podemos modificar lo necesario sin reabrir todo el producto? |
| Comportamiento comprobable | ¿Tenemos evidencia de lo que debe seguir funcionando? |
| Contexto conservado | ¿Quedó escrita la razón de las decisiones difíciles? |
| Entorno preparable | ¿Puede otra persona ejecutar y comprender la aplicación? |
| Complejidad justificada | ¿Cada capa adicional resuelve un problema reconocible? |
| Evolución gradual | ¿Podemos mejorar sin reescribir por reflejo? |
La respuesta puede ser distinta según el proyecto. Lo importante es poder explicar el compromiso elegido y revisar si sigue siendo útil cuando cambian las necesidades.
Cómo se relaciona con las páginas vecinas
Esta hoja establece criterios para construir y evolucionar. La arquitectura de software decide límites y responsabilidades a escala del sistema. Las pruebas aportan evidencia sobre el comportamiento que debe conservarse; la estrategia completa de testing se tratará en su propia hoja editorial. Si una aplicación existente tiene un estado desconocido, la auditoría de software y código ayuda a diagnosticarlo antes de intervenir. La programación a medida es el servicio con el que se construye o evoluciona una solución para una necesidad empresarial.
40 / Preguntas habituales
¿Qué significa que un software sea mantenible?
Que sea posible entenderlo, modificarlo, comprobarlo y entregarlo con un coste y un riesgo razonables para su función y su complejidad. No significa que cualquier cambio sea trivial.
¿Código claro y software mantenible son lo mismo?
El código claro ayuda, pero también importan los datos, las dependencias, las pruebas, el entorno, las decisiones conservadas y la forma de entregar nuevas versiones.
¿Hay que eliminar toda la duplicación o todas las dependencias?
No. Dos fragmentos parecidos pueden responder a decisiones diferentes, y cualquier aplicación útil depende de otras piezas. Nos preocupa duplicar una misma regla que debe cambiar junta o crear dependencias cuyo alcance nadie comprende.
¿Más abstracciones o microservicios mejoran la mantenibilidad?
Sólo si resuelven un problema real mejor que una estructura más sencilla. Un monolito bien organizado puede ser más fácil de comprender y operar; separar servicios añade contratos, fallos de comunicación y trabajo operativo.
¿Aplicamos siempre SOLID o Clean Architecture?
Sus ideas pueden ayudar a examinar responsabilidades y dependencias. No utilizamos una lista de principios o una arquitectura con nombre como puntuación automática ni la imponemos a todo proyecto.
¿Hay que eliminar toda la deuda técnica?
No. Corregirla cuesta y puede introducir riesgos. Priorizamos aquella que dificulta cambios previstos, causa trabajo repetido o aumenta de forma importante el efecto de un fallo.
¿Cuándo merece la pena refactorizar o reescribir?
Refactorizamos cuando reorganizar una zona concreta hace más seguro o económico un cambio relevante y podemos comprobar que el comportamiento se conserva. Reescribir requiere comparar también la recuperación de reglas, datos e integraciones del sistema anterior; la edad del código no decide por sí sola.
¿Las pruebas bastan para que el software sea mantenible?
No. Reducen incertidumbre sobre comportamientos comprobados, pero no sustituyen responsabilidades claras, datos comprensibles o un entorno que otra persona pueda preparar.
¿Docker garantiza continuidad?
Puede ayudar a preparar entornos, pero no documenta decisiones de negocio, no corrige dependencias ocultas ni sustituye la gestión de accesos y secretos.
¿Puede otro proveedor continuar un desarrollo de dev2bit?
El objetivo es que los elementos acordados de repositorio, documentación, entorno y entrega permitan una vía razonable de continuidad. Las condiciones concretas se fijan con el cliente en cada proyecto; una aplicación compleja siempre exigirá aprendizaje.
41 / La pregunta con la que termina cada cambio
La mantenibilidad se decide muchas veces en cambios pequeños: dónde colocamos una regla, qué dependencia aceptamos, qué comprobación añadimos y qué motivo dejamos escrito. Ninguna decisión aislada garantiza un futuro sencillo. Juntas pueden hacer que el siguiente cambio empiece con un mapa en lugar de una excavación.
Cuando una aplicación ya es difícil de modificar, el primer paso no siempre es programar. Puede ser delimitar el problema, reconstruir el comportamiento y decidir qué riesgo merece reducirse primero. Si necesitas desarrollar o continuar una solución empresarial, el alcance comercial está en programación y software a medida; si antes necesitas conocer el estado de una base existente, puedes empezar por una auditoría de software y código.
La prueba más útil de la calidad llega cuando hay que cambiar algo importante y el sistema permite hacerlo sin perder de vista lo que ya funciona.
Francisco Javier Bohórquez Ogalla · Desarrollo de software y dirección técnica en dev2bit. Perfil profesional.