Tu web devuelve un error 500. Antes de cambiar configuraciones o desactivar módulos, conviene entender qué está diciendo esa respuesta y qué información falta para encontrar la causa.
Qué significa realmente un error HTTP 500
Abres tu web y la portada funciona. Entras en un producto y también. Pero al confirmar el pedido aparece una pantalla con este mensaje:
500 Internal Server Error¿Se ha caído la tienda? ¿Ha fallado el pago? ¿El pedido se ha guardado?
El error 500, por sí solo, no responde a ninguna de esas preguntas. Indica que el servidor ha encontrado una situación inesperada que le ha impedido completar la petición. Esa es la definición del código HTTP 500 en el estándar que regula las respuestas web.
Para entenderlo, conviene separar tres cosas: lo que has pedido, lo que ha ocurrido al procesarlo y la respuesta que has recibido.
Una petición, un fallo y una respuesta incompleta
Cada vez que abres una página o envías un formulario, el navegador solicita una operación. La web debe procesarla y devolver una respuesta.
- 01 · Navegador«Muéstrame este pedido»Envías una petición a la web.
- 02 · AplicaciónConsulta y preparaciónLa web busca los datos e intenta construir la página.
- 03 · Fallo inesperadoLa operación se interrumpeNo puede completarse con normalidad.
- 04 · RespuestaHTTP 500Tu navegador recibe el código, sin conocer la causa.
Esquema ilustrativo: el fallo puede producirse en distintos puntos.
El navegador recibe el resultado visible: no se ha podido completar la operación con normalidad. Pero el número 500 no identifica qué componente falló, qué línea de código intervino ni qué información llegó a guardarse antes del error.
Qué sabe el servidor y qué nos está contando
El mensaje también puede aparecer como «HTTP Error 500», «Internal Server Error» o «Error interno del servidor». La pantalla puede llevar el diseño de tu web, el logotipo del alojamiento o apenas una línea de texto.
Esa presentación ayuda poco a identificar la causa.
En ocasiones, el sistema ha registrado un detalle preciso: una excepción de la aplicación, un archivo que no pudo abrir o una operación que agotó sus recursos. En otras, el registro es insuficiente y habrá que reconstruir lo ocurrido.
La respuesta pública suele ofrecer mucha menos información que esos registros internos. Esto evita que el visitante vea detalles técnicos que podrían incluir rutas, consultas o información sensible.
Por tanto, al leer «error interno del servidor» no debemos interpretar automáticamente «el equipo del hosting está averiado». “Servidor” describe el lado que devuelve el error; no señala por sí mismo al responsable. El origen podría estar en el código de la aplicación, su configuración o alguna dependencia.
Por qué el mensaje 500 no es un diagnóstico
Pensemos en dos situaciones hipotéticas:
| Lo que sucede | Lo que ve el visitante |
|---|---|
| Una actualización introduce un fallo que impide ejecutar una página. | Error 500 |
| Una exportación falla al intentar procesar demasiados datos de una vez. | Error 500 |
La pantalla puede ser idéntica. Sin embargo, las comprobaciones necesarias y la corrección serán diferentes.
El código nos permite reconocer una clase de fallo, pero no justifica todavía desactivar un módulo, restaurar una copia o aumentar la memoria. Para decidir entre esas acciones necesitamos una pista más concreta.
También conviene distinguir entre una web que muestra el texto «error 500» y una petición que devuelve realmente el estado HTTP 500. Una página de error mal configurada podría mostrar ese mensaje y responder con otro código. Durante el diagnóstico comprobaremos la respuesta real, además de lo que aparece en pantalla.
Diferencia entre los errores 500, 502, 503 y 504
Los cuatro pertenecen a la familia de errores HTTP 5xx, pero comunican situaciones distintas:
| Código | Qué comunica |
|---|---|
| 500 Internal Server Error | Una condición inesperada ha impedido completar la petición. |
| 502 Bad Gateway | Un servidor intermediario ha recibido una respuesta no válida de otro servidor. |
| 503 Service Unavailable | El servicio no puede atender la petición en ese momento, por ejemplo por sobrecarga o mantenimiento. |
| 504 Gateway Timeout | Un servidor intermediario no ha recibido a tiempo la respuesta que necesitaba de otro servidor. |
Estas diferencias están definidas en el estándar HTTP. Orientan la investigación, aunque tampoco identifican por sí solas la causa raíz.
Sabemos que una petición ha fallado, pero todavía no sabemos por qué ni hasta dónde llegó a ejecutarse.
La siguiente pista está en el contexto: qué estabas haciendo, desde cuándo ocurre y qué cambió antes de que apareciera.
Antes de cambiar nada: reconstruye qué ocurrió
«La web da error 500» describe un síntoma. «Desde las 10:20, los clientes que aplican un cupón reciben un 500 al confirmar el carrito» ya delimita un problema que podemos investigar.
La diferencia está en el contexto. Antes de desactivar extensiones o modificar configuraciones, dedica unos minutos a recoger cinco datos: cuándo empezó, qué cambió, dónde ocurre, con qué frecuencia y a quién afecta. No necesitas conocer todavía la causa para dejar una descripción útil.
¿Cuándo empezó? Busca la última vez que funcionó
La hora a la que alguien avisa no tiene por qué ser la hora a la que empezó el fallo. Un cliente puede encontrar un error por la mañana en una función que nadie utilizaba desde la noche anterior.
Por eso, resulta más útil acotar una franja que inventar una hora exacta:
- 09:42 · FuncionabaÚltima operación correctaSe completó un pedido con cupón.
- 09:50 · Cambio registradoSe actualizó un móduloEs una pista temporal, todavía no una causa demostrada.
- 10:03 · Primer fallo conocidoUn carrito devuelve un 500Tenemos una hora concreta que contrastar con los registros.
- 10:20 · AvisoEl equipo detecta la incidenciaEl problema ya existía antes del aviso.
Ejemplo ficticio. El intervalo entre el último éxito y el primer fallo ayuda a centrar la investigación.
Anota la fecha y la zona horaria: «24 de septiembre, 10:03, hora peninsular española» es más preciso que «esta mañana». Los registros del servidor pueden utilizar otra zona horaria; esa diferencia importa cuando intentamos relacionar acontecimientos.
¿Qué cambió inmediatamente antes?
Revisa tanto los cambios visibles como los automáticos. Puede haber una actualización de un plugin o módulo, una publicación de código, un cambio de PHP, una modificación de configuración o una importación de datos. También puede haber intervenido el proveedor del alojamiento.
La pregunta útil no es solo «¿has tocado algo?», sino «¿qué ha cambiado en el sistema desde la última operación correcta?». Incluye quién realizó el cambio, a qué hora y, si está disponible, qué versión quedó instalada.
Que un error aparezca después de una actualización convierte esa actualización en una hipótesis razonable. No demuestra por sí solo que sea la responsable: pudo coincidir con otra operación o activar un fallo previo que hasta entonces no se manifestaba.
Si no encuentras cambios, escribe «sin cambios identificados». Es una descripción más útil que «no ha cambiado nada»: todavía quedan por comprobar tareas programadas, actualizaciones automáticas y dependencias externas.
¿Falla toda la web o solo una URL o una acción?
Una portada que carga correctamente no demuestra que toda la web funcione. Tampoco el fallo de una página significa que el sitio entero esté caído. Delimita qué parte sigue operativa y en qué punto aparece el error.
| Lo que observas | La distinción que conviene registrar |
|---|---|
| La portada abre, pero un producto falla. | Qué URL concreta falla y si sucede también con otros productos. |
| El formulario se muestra, pero falla al enviarlo. | La página carga; el problema aparece al ejecutar la acción. |
| La tienda funciona, pero el administrador devuelve un 500. | El acceso público y el área de gestión no tienen el mismo comportamiento. |
| La página se ve, pero el buscador queda esperando. | Puede fallar una petición secundaria aunque la página principal haya cargado. |
Guarda la dirección y describe los pasos previos. «Entrar en el carrito, introducir el cupón y pulsar Aplicar» permite repetir una comprobación; «falla al comprar» deja demasiadas posibilidades abiertas.
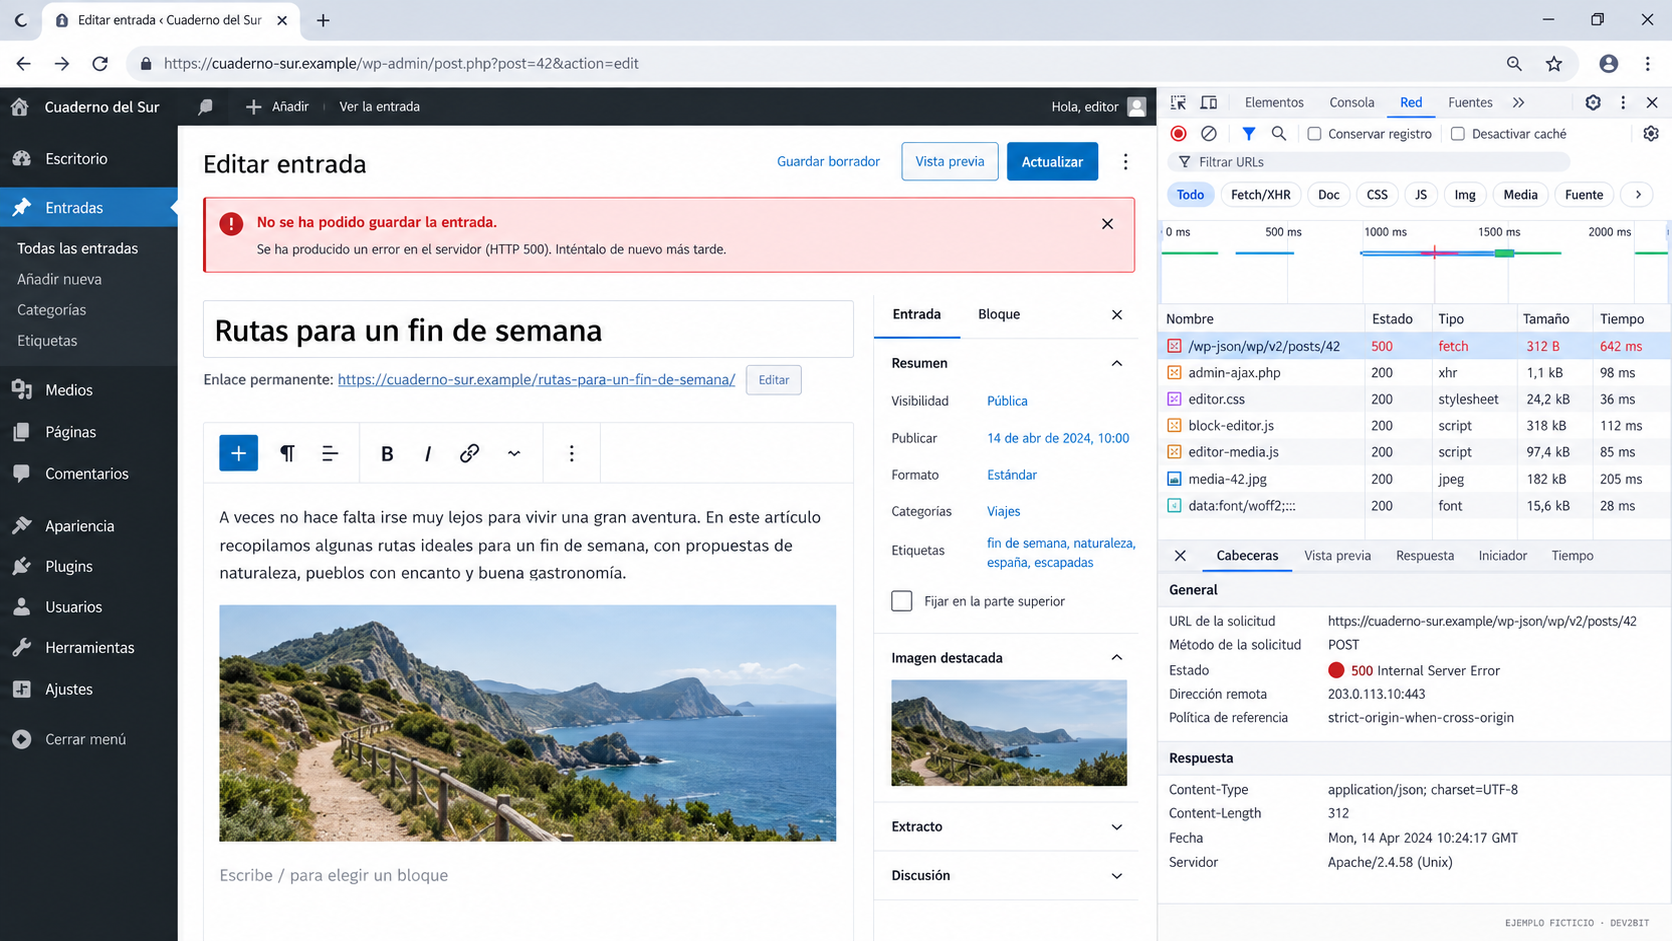
Cuando una acción lanza una petición en segundo plano, la dirección que falla puede ser distinta de la que muestra la barra del navegador. Si dispones de conocimientos para revisar la pestaña Red del navegador, anota la petición que devuelve el 500. Si no, una descripción precisa de la acción ya aporta información valiosa.
¿Ocurre siempre o solo algunas veces?
Un error permanente facilita repetir una misma comprobación. Uno intermitente exige conservar las condiciones de cada aparición: hora, operación, usuario y resultado.
Evita resumirlo como «a veces funciona». Es mejor escribir: «De los tres intentos de abrir el informe, dos fallaron, a las 11:02 y a las 11:07; el de las 11:04 funcionó». Son observaciones limitadas, no una medición de la tasa de fallos de toda la web.
Si sospechas que ocurre cuando hay más visitas, anota la coincidencia sin darla por probada. Que una incidencia aparezca en hora punta no demuestra saturación. Habrá que contrastarla con los registros y las métricas del mismo intervalo.
¿Afecta a todos los usuarios?
Comprueba si existe una diferencia clara entre las personas afectadas: visitantes sin sesión frente a clientes identificados, un perfil de permisos concreto, un idioma o un tipo de pedido. No hace falta probar todas las combinaciones posibles: empieza por la condición que distingue el caso que falla del que funciona.
Por ejemplo, si un producto abre para un visitante pero falla para un cliente identificado, ya tienes una comparación útil. El siguiente paso será investigar qué cambia entre ambas peticiones, sin concluir todavía que la cuenta del cliente esté dañada.
Probar sin sesión puede ayudar a establecer esa diferencia, pero que funcione en una ventana privada no demuestra que «el problema sea la caché». También cambian las cookies, la sesión y otros datos de la petición.
La ficha de incidencia: cinco minutos que evitan muchas suposiciones
Recoge lo observado en una nota compartida con quien vaya a investigar. Esta ficha sirve como punto de partida; deja como «desconocido» cualquier dato que aún no tengas.
| Dato | Qué anotar |
|---|---|
| Inicio | Última operación correcta y primer fallo conocido, con fecha, hora y zona horaria. |
| Cambio previo | Actualización, despliegue o modificación identificada; hora y versión si se conocen. |
| Lugar y acción | URL afectada, pasos previos y petición que falla si está identificada. |
| Frecuencia | Si se repite siempre o de forma intermitente; horas de ejemplos concretos. |
| Personas afectadas | Condiciones relevantes: con o sin sesión, perfil, idioma u otra diferencia observada. |
| Evidencias | Mensaje exacto, captura y referencia de la operación o identificador de petición si existe. |
Comparte las evidencias por un canal privado. Oculta contraseñas, cookies de sesión, tokens y datos personales innecesarios; una captura o una URL pueden contenerlos.
Al terminar, la descripción inicial puede convertirse en algo así:
«El carrito devuelve HTTP 500 al aplicar un cupón con la sesión iniciada. El primer fallo conocido es de las 10:03; a las 09:42 se completó la misma operación. A las 09:50 se actualizó un módulo. La portada y las fichas de producto siguen funcionando. Falta comprobar si afecta a todos los cupones.»
El ejemplo es ficticio y todavía no identifica al responsable. Pero ya permite buscar evidencias concretas, comparar casos y plantear una prueba controlada. El siguiente paso será localizar en qué capa de la web se produce el fallo.
Localiza la capa que falla antes de elegir una solución
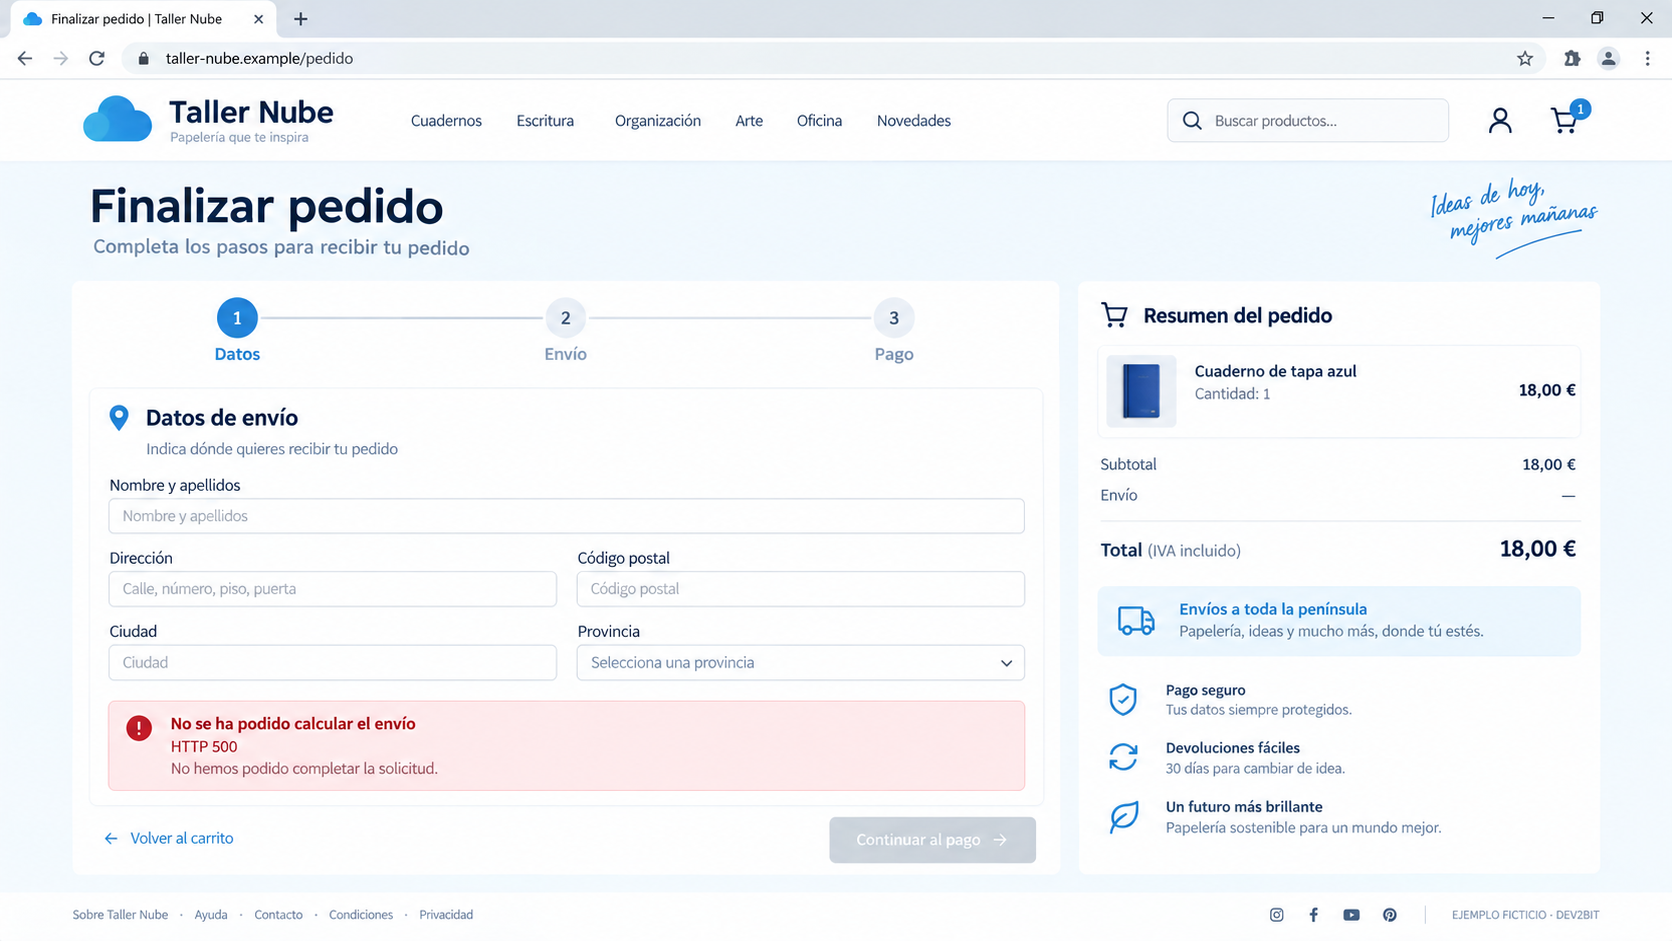
Una tienda puede mostrar un error 500 al calcular los gastos de envío aunque sus productos, su carrito y su base de datos sigan funcionando. Tal vez la aplicación haya recibido una respuesta inesperada del transportista y no haya sabido manejarla. O tal vez ni siquiera haya llegado a consultarlo.
La diferencia cambia por completo la investigación. Antes de decidir qué corregir, necesitamos saber hasta dónde llegó la petición y dónde dejó de funcionar. Para eso conviene dibujar un mapa sencillo de los componentes que intervienen.
El recorrido de una petición: no todo ocurre en el mismo lugar
Cuando visitas una web, tu navegador puede comunicarse con un intermediario, como una CDN o un proxy, antes de llegar al servidor que ejecuta la aplicación. Estos intermediarios pueden reenviar peticiones o responder por sí mismos; su papel está descrito en el estándar HTTP.
Dentro del alojamiento también hay distintas responsabilidades. El servidor web recibe la petición; el entorno de ejecución, como PHP, ejecuta código; y la aplicación decide qué hacer con los datos. Si lo necesita, consulta una base de datos o llama a un servicio externo.
Arquitectura ilustrativa. No todas las webs incluyen estos componentes ni todas las peticiones recorren todos ellos. La base de datos y los servicios externos son dependencias posibles de la aplicación, no pasos obligatorios de una única cadena.
Este mapa representa funciones, no necesariamente máquinas distintas. Varios componentes pueden compartir servidor, y una misma función puede estar repartida entre varios equipos. Para localizar el fallo importa saber quién recibe, quién ejecuta y de quién depende cada operación.
Navegador: identifica qué petición recibe el error
El navegador es nuestro punto de observación. Una página puede abrir correctamente y lanzar después una petición que devuelve un 500: al buscar un producto, guardar un formulario o cargar los gastos de envío.
La pregunta aquí es concreta: ¿falla el documento principal o una petición posterior? En la pestaña Red de las herramientas del navegador puedes distinguir la dirección solicitada, el método —por ejemplo, GET o POST— y el código de respuesta.
Un error de JavaScript en la consola no equivale automáticamente a un error HTTP 500. Puede impedir que se envíe una petición, aparecer al intentar interpretar una respuesta fallida o ser una incidencia independiente. Conserva la relación entre acción, petición y respuesta; no atribuyas al servidor todos los mensajes de la consola.
CDN y proxy: distingue quién entrega el error de quién lo genera
Una CDN puede servir contenido almacenado y reenviar otras peticiones al servidor de origen. Un proxy también puede actuar como punto de entrada y distribuir el tráfico. Si existe un intermediario, hay que averiguar si generó la respuesta de error o si recibió ese error de otro componente y se limitó a devolverlo.
Que la pantalla lleve el logotipo de un proveedor no resuelve esa duda. Tampoco una cabecera que identifica un servidor demuestra que ese servidor sea la causa: describe parte del recorrido de la respuesta.
Una portada almacenada en caché podría seguir visible mientras una operación dinámica falla en el origen. Por eso, «la portada funciona» y «el servidor de la aplicación está funcionando correctamente» son comprobaciones diferentes.
Apache o Nginx: comprueba si la petición llega a la aplicación
El servidor web puede servir un archivo directamente o entregar una petición a otro proceso. Esta distinción ayuda a situar el fallo: una imagen que carga correctamente no prueba que PHP o el CMS estén funcionando.
En esta capa interesa establecer si la petición fue recibida y si pudo encaminarse hacia el componente que debía procesarla. Un problema de configuración puede detenerla antes de ejecutar la aplicación; en otros casos, el servidor web devuelve un error que recibió de esta.
No todos los fallos de comunicación entre componentes se presentan como un 500: pueden producir otros estados, como 502 o 504. El código observado y los registros deben guiar la investigación, sin asumir que cualquier error de servidor tiene el mismo origen.
PHP y aplicación: separa el entorno del código que ejecuta
PHP es el entorno que ejecuta muchas webs; WordPress, PrestaShop o una aplicación a medida contienen el código que realiza sus operaciones. Aunque trabajen juntos, conviene distinguir sus responsabilidades.
Un proceso que no puede iniciar la ejecución plantea una investigación distinta de una aplicación que arranca, reconoce al usuario y falla al ejecutar una función concreta. En el segundo caso, parte del recorrido ya se ha completado.
Que aparezca un error de PHP tampoco demuestra que «PHP esté mal». Puede estar informando de un problema del código que ejecuta o de un recurso que ese código necesita. La pregunta útil es en qué punto se interrumpió la ejecución y qué estaba intentando hacer.
Base de datos: busca una operación fallida, no un culpable por descarte
Una aplicación puede necesitar consultar precios, cargar una sesión o guardar un pedido. Si una de esas operaciones falla y la aplicación termina devolviendo un 500, la base de datos entra en la investigación como una dependencia concreta.
Eso no implica necesariamente que toda la base de datos esté caída. Puede fallar una consulta, una conexión o una operación particular mientras otras siguen funcionando. A la inversa, ver productos en pantalla no garantiza que la conexión actual sea correcta: esos datos podrían proceder de una caché.
Necesitamos una evidencia que vincule el fallo con esa operación. «La página usa base de datos» no basta para justificar reparaciones o cambios en ella.
Servicios externos: el fallo puede estar al otro lado de una llamada
Algunas acciones dependen de una pasarela de pago, un transportista, un ERP o una API. Si esa dependencia responde con un error, tarda demasiado o devuelve un formato inesperado, la aplicación debe decidir cómo manejarlo.
Según cómo esté programada, puede mostrar un aviso controlado o acabar devolviendo un 500. El código que ve el visitante no tiene por qué ser el mismo que devolvió el servicio externo. Incluso una respuesta HTTP correcta de la API podría contener datos que la aplicación no sabe procesar.
Qué puedes concluir con cada pista
| Pista observada | Qué permite investigar | Qué no demuestra |
|---|---|---|
| La página abre, pero una petición posterior devuelve 500. | La operación concreta que ejecuta esa petición. | Que toda la web esté caída. |
| Los archivos estáticos cargan, pero las páginas dinámicas fallan. | El recorrido hacia el entorno de ejecución y la aplicación. | Que el servidor web no intervenga en el fallo. |
| La aplicación registra una excepción al consultar datos. | La consulta o conexión relacionada con esa petición. | Que toda la base de datos esté averiada. |
| El error aparece al utilizar una integración. | La llamada externa y cómo procesa la aplicación su respuesta. | Que el proveedor externo sea necesariamente responsable. |
Por ejemplo: «La petición llega a la aplicación, pero falla durante el cálculo del envío». Todavía falta explicar la causa, pero ya sabemos dónde buscar la siguiente evidencia.
Para confirmar ese recorrido necesitamos relacionar lo ocurrido en los distintos componentes con una misma petición. Ahí entran los logs: en la siguiente sección veremos dónde buscarlos y cómo leerlos sin perdernos entre errores ajenos a la incidencia.
Los logs: dónde buscar la explicación del error 500
Ya sabes qué operación falla y qué componentes intervienen. Ahora necesitas encontrar una evidencia que permita avanzar: qué registró el sistema mientras atendía esa petición.
Un log es un registro de acontecimientos. Puede indicar qué dirección se solicitó, qué respuesta se devolvió o en qué punto se interrumpió una ejecución. Pero no es un diagnóstico listo para copiar: mezcla actividad normal, avisos y fallos que pueden pertenecer a usuarios y momentos distintos.
El objetivo no es encontrar cualquier línea que diga «error». Es encontrar la que corresponde a tu incidencia y entender qué permite concluir.
Empieza por la petición, no por el último mensaje del archivo
Recupera la ficha de la sección anterior: hora con zona horaria, dirección afectada, acción realizada e identificador de petición si existe. Utiliza esos datos para acotar la búsqueda.
En una web con actividad, el último error del archivo podría pertenecer a otra persona. Incluso dos mensajes del mismo segundo pueden corresponder a peticiones distintas. La coincidencia temporal es una pista; compartir un identificador de petición ofrece una relación mucho más precisa, siempre que los componentes lo conserven y lo registren correctamente.
No todas las instalaciones tienen ese identificador. Si falta, combina hora, ruta, método y contexto de la operación, y deja explícito lo que todavía no puedes relacionar con seguridad.
Qué aporta cada tipo de registro
| Registro | Qué buscar | Qué puede faltar |
|---|---|---|
| Acceso del servidor web | La petición, su hora y el estado HTTP registrado. Según el formato, también duración e identificador. | La explicación del fallo dentro de la aplicación. |
| Errores de Apache o Nginx | Problemas al procesar o encaminar la petición y al comunicarse con otros procesos. | Excepciones que la aplicación registra por su cuenta. |
| PHP o su gestor de procesos | Errores de ejecución, fallos de arranque o mensajes relacionados con el proceso que atiende la web. | El contexto de negocio: pedido, operación o integración afectada. |
| Aplicación o CMS | Excepción, operación afectada y recorrido del código cuando esté disponible. | Fallos que ocurrieron antes de que la aplicación pudiera iniciarse. |
Apache diferencia los registros de acceso y de error y permite configurar sus ubicaciones y formatos. También puede incluir un identificador que ayude a relacionar ambos. La documentación oficial de logs de Apache explica esas posibilidades.
Una respuesta 500 puede aparecer en el registro de acceso sin una explicación detallada en el de errores. Eso no significa que no haya ocurrido nada: quizá el detalle esté en el registro de la aplicación o no se esté capturando.
Dónde están los logs: confirma la instalación que estás mirando
No existe una ruta universal válida para todos los alojamientos. En un hosting gestionado, empieza por el apartado de registros o errores del dominio. Si no permite consultarlos, pide al soporte el intervalo y la petición concretos; «necesito los logs de la web» suele producir una respuesta menos útil.
Con acceso al servidor, la configuración activa indica el destino de los registros. En Nginx, por ejemplo, la directiva error_log permite definir destinos y niveles de registro. No conviene asumir que el archivo de otra instalación será el correcto para esta.
En entornos con contenedores o varios servidores, los mensajes también pueden enviarse a la salida del proceso o a una plataforma centralizada. Comprueba qué instancia atendió la petición: un archivo vacío en un equipo no descarta un fallo registrado en otro.
Antes de interpretar resultados, verifica tres cosas: dominio correcto, entorno de producción correcto e intervalo correcto. Revisa también la rotación: los registros de ayer podrían estar en un archivo anterior, comprimidos o fuera del periodo de conservación.
Un ejemplo: unir las piezas de una misma petición
Imagina que al calcular el envío la aplicación falla. Estos mensajes ficticios muestran cómo podrían relacionarse los acontecimientos si existe un identificador compartido:
14:32:04.180  APLICACIÓN  req=demo-7f2
Inicio de cálculo de envío

14:32:04.460  APLICACIÓN  req=demo-7f2
Excepción: la respuesta no contiene la tarifa esperada

14:32:04.475  ACCESO      req=demo-7f2
POST /calcular-envio → HTTP 500
Ejemplo didáctico: formato simplificado, horas en una misma zona e identificador inventado. No son registros de un cliente ni un formato que todas las webs generen.
La última línea confirma que esa petición terminó con un 500. La excepción anterior sitúa el fallo en el tratamiento de la tarifa. El identificador permite relacionarlas sin depender únicamente de que ocurrieran cerca en el tiempo.
Todavía falta una comprobación: ¿qué recibió realmente la aplicación y qué esperaba recibir? El registro orienta la investigación, pero no demuestra por sí solo si cambió la respuesta del proveedor, si se envió una petición incorrecta o si el código interpretó mal un dato válido.
Además, no todos los registros anotan el mismo momento: unos reflejan la recepción de una petición y otros su finalización. Si una operación tarda varios segundos, busca una ventana alrededor del fallo y comprueba el significado de las marcas temporales antes de ordenar los hechos.
Cómo leer un mensaje sin saltar a una solución
Lee el mensaje completo y unas líneas de contexto. Si hay una traza de excepción —la secuencia de llamadas que llevó al fallo—, conserva esa secuencia: copiar únicamente la última línea puede ocultar la operación que desencadenó el problema.
| El registro indica… | La siguiente pregunta es… |
|---|---|
| Se agotó la memoria permitida durante la ejecución. | ¿Qué operación la estaba consumiendo y con qué cantidad de datos? |
| No se pudo abrir un archivo. | ¿Qué ruta se intentó abrir y qué detalle da el mensaje: ausencia, permisos u otro motivo? |
| Falló una conexión con la base de datos. | ¿Cuál es el error concreto y corresponde a la misma petición que devolvió el 500? |
| Se lanzó una excepción en una integración. | ¿Qué respuesta o dato estaba procesando y qué esperaba encontrar? |
El archivo y la línea señalados indican dónde se manifestó el fallo. No siempre indican dónde nació: una función puede recibir datos incorrectos desde otro componente y romperse al utilizarlos.
También conviene distinguir avisos de errores que interrumpen la operación. Un aviso antiguo sobre una función obsoleta puede coexistir con el 500 sin provocarlo. En algunas aplicaciones, el tratamiento de los avisos cambia su efecto; por eso hay que comprobar su relación con la petición y no decidir solo por la etiqueta del mensaje.
Si no aparece nada, comprueba qué se está registrando
La ausencia de un mensaje no demuestra la ausencia del fallo. Puede que estés consultando otro destino, que el nivel de registro no incluya ese detalle, que la petición no haya alcanzado el componente o que el proceso no haya podido escribir.
Confirma primero la configuración existente. Si hace falta ampliar el registro, hazlo para el componente y el intervalo necesarios, con control del espacio disponible y una forma de volver a la configuración anterior. Recoger más información indiscriminadamente puede añadir ruido y datos sensibles sin aclarar la incidencia.
Registrar errores no es mostrárselos al visitante
En PHP, log_errors y display_errors cumplen funciones diferentes: registrar errores y mostrarlos en la salida. La documentación de PHP desaconseja mostrar esos detalles en sistemas de producción.
Para investigar una web pública necesitamos un registro privado, no una pantalla con rutas internas, consultas o trazas visibles para cualquiera. Si una prueba requiere más detalle, limita su alcance y evita volcar credenciales, cookies, tokens o cuerpos completos de peticiones con datos personales.
Al terminar esta revisión deberías poder formular una observación verificable: «Esta petición devolvió un 500 y, durante su ejecución, la aplicación registró esta excepción». Esa relación será el punto de partida para evaluar las causas posibles y elegir una comprobación concreta.
Las causas más frecuentes de un error 500 y cómo distinguirlas
Dos webs pueden devolver el mismo error 500 y necesitar correcciones completamente diferentes. Ahora que sabemos situar la incidencia y buscar sus registros, podemos evaluar las causas con algo más que intuición.
Los siguientes escenarios son habituales en el diagnóstico de aplicaciones web. No están ordenados por probabilidad: la pista que encaje con tu petición y tus registros debe marcar el siguiente paso.
1. Un error de código interrumpe la ejecución
Una función recibe un dato que no esperaba, intenta utilizar un objeto inexistente o llama a un método que no está disponible. Si la aplicación no controla ese fallo, la petición puede terminar con un 500.
Por ejemplo, una ficha de producto puede funcionar hasta que encuentra un artículo sin imagen. Si el código presupone que todos tienen una y utiliza sus propiedades sin comprobarlo, el fallo aparece únicamente en ese caso.
Qué buscar: una excepción o un error de ejecución vinculado a la petición, con su mensaje y traza. Comprueba qué dato y qué recorrido activan el fallo. La línea señalada es el lugar donde se manifiesta; el origen puede estar en una validación anterior.
2. Un plugin, módulo o extensión resulta incompatible
Una extensión puede depender de una versión concreta del CMS, de una biblioteca o de otra extensión. El problema también puede aparecer cuando dos componentes modifican la misma operación con supuestos distintos.
Que el nombre de un módulo aparezca en la traza lo convierte en un componente que revisar, no en un culpable automático. Podría estar recibiendo datos incorrectos de otra parte de la aplicación.
Qué buscar: versiones instaladas, requisitos de compatibilidad y cambios recientes. Una prueba aislada en una copia del entorno puede mostrar si el fallo depende de esa extensión. Desactivar varias a la vez dificulta saber cuál alteró el resultado y puede interrumpir funciones necesarias de la tienda.
3. Una actualización o un despliegue queda incompleto
El código nuevo puede necesitar archivos, dependencias o cambios de base de datos que todavía no están disponibles. Si solo se actualiza una parte, la aplicación queda en un estado incoherente: una pieza espera algo que otra aún no proporciona.
También puede haber diferencias entre las instancias que atienden tráfico. Si una quedó con otra versión, el comportamiento podría variar según qué instancia recibe la petición.
Qué buscar: el resultado del despliegue, las versiones realmente activas y los pasos pendientes. Mensajes sobre clases ausentes o estructuras de datos inesperadas pueden orientar la revisión, pero no demuestran por sí solos una actualización incompleta. Antes de revertir, hay que comprobar si el cambio modificó datos y si la versión anterior puede utilizarlos.
4. La configuración del servidor impide procesar la petición
Una directiva no válida, una regla de reescritura que entra en un bucle o una configuración que no corresponde al entorno pueden impedir que la petición llegue a ejecutarse correctamente.
En Apache, un archivo .htaccess puede intervenir si la configuración permite utilizarlo. No todas las instalaciones lo admiten, y Nginx no utiliza estos archivos. Por eso, renombrar .htaccess no es una solución universal para un error 500.
Qué buscar: el mensaje del servidor web y el cambio de configuración que coincide con el inicio del fallo. Revisa la directiva o regla concreta. Eliminar reglas sin conocer su función puede afectar a las rutas, los controles de acceso o el comportamiento de la web.
5. La versión de PHP o sus extensiones no coincide con lo que necesita la aplicación
Después de cambiar PHP, un código que antes funcionaba puede utilizar funciones o comportamientos que ya no están disponibles. También puede faltar una extensión de PHP necesaria para una operación determinada.
No basta con consultar la versión que muestra una consola: la web puede estar atendida por otro proceso o configuración de PHP. Lo relevante es el entorno que ejecuta la petición afectada.
Qué buscar: la versión efectiva de la web, sus extensiones cargadas y los requisitos del CMS y sus componentes. Relaciona esa información con el mensaje concreto del error. Volver a una versión anterior puede servir como mitigación controlada en algunos casos, pero no sustituye la corrección de una incompatibilidad ni justifica mantener indefinidamente una versión sin soporte.
6. La operación agota la memoria disponible para su ejecución
Una exportación que carga miles de registros a la vez, el procesamiento de una imagen grande o una operación que acumula datos pueden superar el límite de memoria del proceso. El registro puede señalar que se agotó la memoria permitida.
Qué buscar: qué operación consumía memoria, qué volumen de datos manejaba y si el fallo se repite a partir de cierto tamaño. Aumentar el límite podría permitir que termine, pero también ocultar un consumo que sigue creciendo o trasladar el problema al conjunto del servidor.
7. La ejecución supera un límite de tiempo
Una operación puede demorarse por una consulta costosa, una llamada externa o un procesamiento prolongado. Si alcanza un límite de ejecución, puede interrumpirse antes de preparar la respuesta.
Hay distintos relojes en juego: el de la aplicación, el del proceso que ejecuta el código y el de un intermediario que espera una respuesta. Según dónde se alcance el límite y cómo se gestione, el visitante podría recibir un 500 u otro estado, como un 504.
Qué buscar: la duración de la petición y el mensaje del componente que dejó de esperar o ejecutar. Subir todos los tiempos a la vez impide distinguir el límite implicado y puede mantener ocupados recursos durante más tiempo sin resolver la operación lenta.
8. El proceso no puede acceder a un archivo o directorio
Una aplicación puede necesitar leer su configuración, escribir una caché o guardar un archivo temporal. Si el usuario que ejecuta ese proceso no dispone del acceso necesario, la operación puede fallar.
Este escenario aparece, por ejemplo, después de copiar archivos con un propietario distinto. Pero un mensaje de acceso fallido también puede deberse a una ruta incorrecta, a un archivo ausente o a otras restricciones del entorno.
Qué buscar: la ruta exacta, el tipo de operación y el usuario efectivo del proceso. Comprueba permisos y propietario en ese contexto. Dar permisos 777 de forma indiscriminada abre accesos innecesarios y no resuelve todos los motivos por los que un archivo puede resultar inaccesible.
9. Falla una operación de base de datos
La aplicación puede perder una conexión, utilizar credenciales incorrectas o intentar ejecutar una consulta incompatible con la estructura existente. Si no maneja ese fallo, puede terminar devolviendo un error 500.
El mensaje concreto importa: una conexión rechazada no se investiga igual que una columna inexistente. Tampoco debe confundirse una consulta fallida con una avería general de la base de datos.
Qué buscar: el código y el detalle del error, la operación asociada y los cambios recientes de configuración o estructura. No ejecutes reparaciones ni restaures datos solo porque una traza mencione la base de datos: primero hay que saber qué condición ha fallado.
10. Una dependencia externa responde de forma inesperada
Una API puede no estar disponible, rechazar las credenciales o devolver una estructura distinta de la esperada. El resultado que ve el visitante depende de cómo la aplicación gestione esa situación.
Qué buscar: la llamada vinculada a la petición, su duración, el estado recibido y el dato que no pudo procesarse. Conserva únicamente la información necesaria y evita registrar secretos o datos personales completos.
Si la aplicación convierte una respuesta controlable del proveedor en un fallo general, puede ser necesario corregir el tratamiento de errores de la integración, además de resolver la condición externa.
De la causa posible a una comprobación concreta
Una hipótesis útil explica lo observado y permite diseñar una prueba limitada. Esta tabla muestra cómo pasar de una pista a una comprobación sin aplicar cambios indiscriminados:
| Evidencia | Comprobación que ayuda a avanzar |
|---|---|
| El fallo comenzó tras un despliegue y falta una clase. | Comparar los archivos y dependencias activos con los previstos para esa versión. |
| El registro confirma agotamiento de memoria al exportar. | Relacionar el consumo con el volumen y el modo de procesamiento de los datos. |
| El servidor registra una directiva no válida. | Revisar esa directiva y su compatibilidad con la configuración activa. |
| Solo falla una operación y la traza señala una llamada externa. | Relacionar la petición enviada, la respuesta recibida y el tratamiento que hace el código. |
«Puede ser un módulo» abre una posibilidad. «Esta versión falla con este dato y deja esta excepción» permite decidir una intervención concreta y comprobar después si funciona.
Con estas diferencias claras, el siguiente paso será organizar el diagnóstico según el momento en que apareció el error: después de actualizar, tras una migración, bajo carga o durante una acción determinada.
Un método de diagnóstico según cuándo apareció el error 500
Ya tienes el contexto, el recorrido de la petición y sus registros. Ahora toca decidir por dónde empezar. Un error que surge justo después de cambiar PHP plantea una primera comprobación distinta de otro que solo aparece al exportar un informe.
El momento del fallo sirve para priorizar hipótesis, no para darlas por ciertas. Elige la ruta que mejor describa lo observado y contrástala con las evidencias que has recogido. Si encajan varias, empieza por la que tenga una relación más concreta con la petición afectada.
Las rutas pueden solaparse. Un fallo posterior a una actualización también puede depender de ciertos datos o manifestarse solo bajo carga.
Después de actualizar la aplicación o publicar una versión
Empieza por delimitar la actualización: versión anterior, versión activa, hora del despliegue y componentes afectados. Comprueba si terminó correctamente y si incluía dependencias, cambios de estructura de datos o tareas posteriores.
Busca una relación entre ese cambio y el error. Si el registro indica una clase ausente, revisa si los archivos y dependencias de la versión están completos. Si señala una columna desconocida, contrasta la estructura que espera el código con la que existe. Son comprobaciones distintas, aunque ambas incidencias hayan comenzado tras actualizar.
Prueba útil: reproducir la misma operación en un entorno de pruebas representativo y comparar las versiones manteniendo los datos y las condiciones relevantes. Si se plantea una reversión en producción, confirma antes que la versión anterior sigue siendo compatible con los datos actuales.
Después de instalar o actualizar un plugin o módulo
Identifica qué función añade o modifica la extensión y si interviene en la acción que falla. Un módulo de descuentos encaja como hipótesis cuando el error aparece al aplicar un cupón; esa proximidad funcional merece investigarse, pero no sustituye la traza.
Prueba útil: aislar la extensión implicada en una copia del entorno y repetir la operación bajo las mismas condiciones. Si requiere otras extensiones, ten en cuenta esas dependencias al interpretar el resultado.
Que el error desaparezca al desactivarla demuestra que has alterado el recorrido que lo activaba. Todavía hay que distinguir entre un defecto de la extensión, un conflicto con otro componente y un dato que solo ella procesa. Desactivar la función puede evitar el síntoma sin recuperar el servicio que el usuario necesita.
Después de cambiar la versión de PHP
Comprueba qué versión y configuración atienden realmente la web, junto con sus extensiones cargadas. Contrasta esos datos con los requisitos de la aplicación y sus módulos. La versión disponible por consola puede no ser la que ejecuta la petición web.
Prueba útil: comparar la operación en los dos entornos de ejecución dentro de un entorno controlado, conservando la versión de la aplicación y los datos relevantes. Utiliza el mensaje concreto del registro para buscar la incompatibilidad; no cambies a la vez PHP, el CMS y todas las extensiones.
Si la versión anterior evita el fallo, has acotado una diferencia de entorno. Aún queda identificar qué función, dependencia o configuración necesita adaptarse.
Después de una migración de servidor o alojamiento
Una copia de los archivos no garantiza un entorno equivalente. Pueden cambiar las rutas, el propietario de los archivos, las variables de configuración, las credenciales, las extensiones de PHP o los permisos de conexión hacia otros servicios.
Antes de comparar, confirma qué servidor recibe la petición. Durante una transición puede haber tráfico llegando a destinos distintos; mezclar sus registros haría parecer intermitente un fallo que solo ocurre en uno.
Prueba útil: contrastar el entorno anterior y el nuevo sobre el componente señalado por el error. Si la aplicación no conecta con la base de datos, empieza por el destino y la conexión configurados. Si no puede escribir un archivo, compara ruta, usuario y acceso necesario. No copies configuraciones enteras sin comprobar qué valores pertenecen al alojamiento anterior.
Sin cambios identificados: busca patrones antes de descartar causas
Que nadie haya publicado código no significa que todas las condiciones sigan iguales. Puede haber actualizaciones automáticas, tareas programadas, crecimiento de datos, agotamiento de espacio o cambios en un servicio externo.
Prueba útil: comparar varios fallos con operaciones correctas cercanas en el tiempo. Anota qué comparten y qué cambia: instancia, franja horaria, operación, volumen de datos o dependencia utilizada. Revisa las tareas programadas solo cuando su horario o su actividad encajen con la incidencia.
Si el error aparece cada noche, «ocurre durante la copia de seguridad» es una hipótesis. Para sostenerla necesitas relacionar el intervalo con evidencias de interferencia, espera o consumo de recursos; la coincidencia de horarios por sí sola no explica el mecanismo.
Solo bajo carga: distingue concurrencia, volumen y saturación
«Falla cuando hay mucho trabajo» puede describir situaciones diferentes. Muchas personas a la vez elevan la concurrencia. Un único informe enorme aumenta el volumen de una operación. Una consulta bloqueada puede hacer que se acumulen peticiones aunque no haya un pico de visitas.
Prueba útil: relacionar los errores con las métricas y registros del mismo intervalo. ¿Se acumulan peticiones? ¿El proceso alcanza un límite? ¿Las consultas esperan? ¿El fallo depende del número de usuarios o del tamaño de los datos que procesa cada petición?
Las pruebas de carga deben realizarse en un entorno y con un alcance preparados para ello. Recargar páginas o lanzar peticiones en masa contra la tienda activa puede agravar la incidencia sin producir una comparación útil.
Solo en una acción concreta: compara un caso que funciona con otro que falla
Esta ruta suele permitir acotar mucho la investigación. Si falla un producto pero otro abre, o un pedido provoca un 500 mientras otro se procesa, compara las diferencias relevantes para la operación.
Prueba útil: utilizar casos controlados y variar una condición cada vez: un campo vacío, una combinación de opciones, un perfil de usuario o un tamaño de archivo. No hace falta modificar datos reales del negocio para improvisar la prueba.
Deja escrito qué vas a comprobar y cómo interpretarás el resultado
Antes de intervenir, resume la prueba en una frase. Esto evita encadenar cambios hasta que «parezca funcionar» sin saber cuál influyó.
| Parte de la prueba | Ejemplo hipotético |
|---|---|
| Hipótesis | La nueva versión del módulo falla al procesar un producto sin un dato opcional. |
| Condiciones que mantengo | Misma copia de datos, PHP, configuración y operación en el entorno de pruebas. |
| Variable que comparo | Versión anterior y nueva del módulo, siempre que ambas sean compatibles con esa copia. |
| Resultado que espero | La nueva versión reproduce el fallo y deja la misma excepción; la anterior completa la operación. |
| Si no ocurre lo esperado | La hipótesis pierde apoyo. Reviso las diferencias del entorno y otras evidencias antes de cambiar otra variable. |
| Verificación funcional | Compruebo el resultado de la operación, no solo que haya desaparecido la pantalla de error. |
Una respuesta HTTP correcta puede contener un resultado incorrecto. Si investigas un descuento, comprueba el importe; si es un formulario, comprueba que la información se haya guardado como corresponde.
Este método permite adaptar el diagnóstico al incidente sin perder el hilo de la evidencia. A continuación veremos qué particularidades conviene tener presentes cuando la aplicación es WordPress.
Error 500 en WordPress: qué cambia en el diagnóstico
En WordPress, la petición puede pasar por el núcleo, plugins, el tema y código añadido a medida. El objetivo sigue siendo el mismo: relacionar la operación que falla con una evidencia. Lo particular es identificar qué componente interviene y qué herramientas tienes disponibles para investigarlo.
El aviso «Ha habido un error crítico en esta web» puede acompañar un fallo de ejecución, pero no sustituye la comprobación del estado HTTP ni del registro. Tampoco una pantalla en blanco identifica por sí sola un error 500.
Separa la web pública, el administrador y la acción que falla
Empieza por concretar el alcance: ¿falla una página pública, el acceso a wp-admin, el guardado de una entrada o una petición que ocurre después de pulsar un botón?
| Dónde aparece | Qué interesa identificar |
|---|---|
| Una página pública concreta | Plantilla, bloque o función que utiliza esa página y su relación con el error registrado. |
| Al guardar desde el editor | La petición que falla y el código que interviene durante el guardado. |
| Solo en el administrador | La pantalla y la acción afectadas; los plugins y funciones que se ejecutan en ese contexto. |
| En toda la web, incluido el administrador | El arranque de WordPress, su configuración y los componentes que se cargan antes de mostrar las páginas. |
Esta distinción evita pruebas poco informativas. Cambiar una plantilla porque falla una petición de guardado no tiene el mismo fundamento que revisar una función de esa plantilla señalada en la traza.
Utiliza el modo de recuperación si WordPress lo ofrece
Ante determinados errores fatales, WordPress puede enviar al correo de administración un enlace de recuperación. Ese acceso permite investigar con el componente implicado pausado para la sesión de recuperación. No es una reparación general de la web ni garantiza que todos los visitantes hayan recuperado el servicio. Puedes consultar su funcionamiento en la documentación del modo de recuperación.
Si recibes el aviso, conserva el detalle del error y trata el enlace como un acceso privado. Si no llega, no concluyas que el fallo sea ajeno a WordPress: el envío de correo o el propio arranque pueden no haber completado el proceso.
Plugins y tema: sigue la traza y aísla una diferencia
Una ruta bajo wp-content/plugins/ o wp-content/themes/ ayuda a localizar el código que aparece en el error. Revisa la llamada y sus antecedentes: una extensión puede fallar al recibir un dato de otra, o el tema puede ejecutar una función que ya no existe.
En una copia de pruebas, compara el comportamiento al aislar el componente señalado, manteniendo las demás condiciones. Si la operación depende de él, comprueba también qué función has dejado de ejecutar: eliminar el botón que provoca el error no equivale a arreglar su funcionamiento.
Registra el detalle sin mostrarlo en la página
WordPress dispone de WP_DEBUG, WP_DEBUG_LOG y WP_DEBUG_DISPLAY. Sus funciones son activar la depuración, registrar mensajes y controlar su visualización. El registro de depuración requiere WP_DEBUG activo; ocultar los mensajes no protege por sí solo el archivo donde se guardan.
La guía oficial de depuración de WordPress recomienda estas herramientas para desarrollo y pruebas. También permite indicar una ruta específica para el log, en lugar del destino habitual en el directorio de contenido.
Empieza por los registros privados ya disponibles en el alojamiento. Si necesitas ampliar el diagnóstico, prepara una copia de pruebas y un destino de registro protegido. Antes de editar wp-config.php, conserva su configuración y revisa si las constantes ya están definidas: pegar bloques repetidos añade confusión y puede introducir otro problema.
No publiques el contenido de ese archivo ni una traza completa sin revisar sus datos. Las credenciales y claves de configuración no son necesarias para describir la incidencia a terceros.
PHP y .htaccess: comprueba si la petición llega a WordPress
Si el registro señala una incompatibilidad con PHP, contrasta la versión que ejecuta la web con los requisitos de WordPress y sus componentes. Si el error ocurre antes de que WordPress pueda arrancar, su log de depuración puede no contener la explicación: vuelve al registro de PHP o del servidor web.
En instalaciones que utilizan Apache y admiten .htaccess, las reglas de ese archivo también pueden intervenir. Conserva las reglas actuales y busca el mensaje concreto antes de regenerarlas: pueden incluir ajustes adicionales de acceso o redirección. Si la web utiliza Nginx, la configuración correspondiente está en otro lugar.
Qué acción de WordPress falla, qué petición devuelve el error y qué componente aparece en su registro. Esa relación permite elegir una prueba útil sin desactivar indiscriminadamente funciones de la web.
En la siguiente sección veremos las particularidades de PrestaShop, donde conviene distinguir además el proceso de compra, el catálogo y el Back Office.
Error 500 en PrestaShop: distingue catálogo, compra y Back Office
Una tienda PrestaShop puede mostrar productos con normalidad y fallar al calcular un transporte, validar un pedido o guardar una combinación desde el Back Office. Cada acción ejecuta un recorrido distinto y puede activar módulos y personalizaciones diferentes.
Empieza por identificar qué operación falla y en qué contexto. Registra también la versión exacta de PrestaShop, PHP, el tema y los módulos implicados. Las comprobaciones deben corresponder a esa instalación, no a una receta pensada para otra versión.
El escaparate y el Back Office no prueban lo mismo
| Dónde falla | Qué conviene concretar |
|---|---|
| Ficha de producto o categoría | Producto, combinación, idioma y contexto de cliente. Si afecta a una ficha concreta o a todas. |
| Carrito o checkout | Paso exacto, cupón, dirección, transportista y método de pago implicados. |
| Guardado en Back Office | Formulario y acción que fallan; si cambió algún dato antes del error. |
| Importación o regeneración de imágenes | Volumen procesado, duración, último elemento completado y mensaje del registro. |
Si utilizas multitienda, añade la tienda o grupo seleccionado. Una misma acción puede utilizar configuraciones diferentes según el contexto. Para comparar dos casos, conserva esas condiciones en lugar de cambiar a la vez producto, idioma y usuario.
Módulos y hooks: busca qué se ejecuta durante la acción
Los módulos pueden intervenir en distintos momentos de una operación mediante hooks, puntos de extensión donde PrestaShop ejecuta código adicional. Una acción que parece propia del núcleo puede activar una integración, un cálculo personalizado o una sincronización.
Que un módulo no tenga un bloque visible en la página no significa que no participe. Si el error aparece al guardar un producto, la traza puede conducir a código que se ejecuta después del guardado, por ejemplo para comunicar el cambio a otro sistema.
La documentación de PrestaShop identifica las incompatibilidades de módulos y temas entre los posibles orígenes de estos fallos. Revisa versiones y evidencias antes de actuar, tomando como referencia su guía oficial sobre el error 500.
Desactivar y desinstalar no son pruebas equivalentes. Una desinstalación puede ejecutar operaciones de limpieza según cómo esté construido el módulo. Para aislar un componente, utiliza una copia de pruebas y revisa sus dependencias y comportamiento antes de modificarlo.
Overrides: una personalización puede alterar el comportamiento esperado
Los overrides permiten modificar determinados comportamientos de clases o controladores. Por eso, una investigación no termina al comprobar los archivos del núcleo: puede haber código que cambie su funcionamiento.
PrestaShop advierte de los posibles conflictos entre overrides y de su carácter exclusivo en su documentación para desarrolladores. Si la traza apunta a una personalización, revisa qué método modifica, de dónde procede y si sigue siendo compatible con la versión instalada.
Deshabilitar overrides puede servir como comparación controlada, pero también retirar lógica necesaria para el negocio. Que desaparezca el error después de hacerlo no demuestra que el pedido, el precio o la operación resultante sean correctos.
Versión, PHP y partes modernizadas: localiza el registro adecuado
Según la versión y la pantalla, pueden intervenir componentes heredados y otros basados en Symfony. No todas las acciones siguen el mismo recorrido ni necesariamente dejan sus detalles en el mismo destino de registro.
Comprueba la compatibilidad de PHP con la versión concreta de PrestaShop y con sus módulos. La matriz de requisitos de PrestaShop 8, por ejemplo, corresponde a esa rama: no debe aplicarse automáticamente a una tienda de otra versión.
Prioriza los registros privados del servidor y de la aplicación. Si necesitas depuración adicional, reproduce el caso en un entorno de pruebas protegido. Activar el modo debug en una tienda pública puede mostrar detalles internos; tampoco convierte por sí solo el mensaje en una explicación completa de la causa.
Caché: distingue regenerar datos de corregir el fallo
Después de modificar código o configuración puede ser necesario regenerar información almacenada por la aplicación. Pero «vaciar la caché» no es una explicación del error ni una prueba concluyente.
Antes de hacerlo, conserva la evidencia y determina qué caché interviene en la instalación. Si al regenerarla aparece un error de escritura, habrá que revisar ese acceso. Si el fallo vuelve con la misma operación, la regeneración no ha eliminado su desencadenante.
Evita borrar directorios por similitud de nombre o copiar instrucciones de otra versión. Utiliza el procedimiento correspondiente a la tienda y comprueba después tanto el acceso público como la acción que fallaba.
Además de que desaparezca el error, revisa el resultado de la acción afectada: importes, estado del pedido, stock o dato guardado. La verificación debe corresponder a lo que se estaba intentando hacer.
En la siguiente sección reuniremos las actuaciones que conviene evitar para no agravar la incidencia ni perder las evidencias necesarias para resolverla.
Qué no hacer cuando aparece un error 500
Con la web fallando, es fácil encadenar acciones: desactivar un módulo, vaciar la caché, cambiar PHP y restaurar una copia. Si después vuelve a funcionar, queda una pregunta incómoda: ¿qué cambio resolvió el problema y qué más hemos alterado?
Una intervención útil debe reducir la incertidumbre o recuperar una función necesaria. Si modifica muchas cosas sin conservar el estado anterior, puede crear una segunda incidencia y borrar las pistas de la primera.
No restaures una copia sin comprobar qué vas a sobrescribir
Una copia de seguridad representa un momento anterior. Desde entonces puede haber pedidos, pagos, formularios, cambios de stock o trabajo del equipo. Restaurar toda la base de datos puede eliminar información que no tiene relación con el error.
En su lugar: identifica si la reversión necesaria afecta a código, configuración o datos. Conserva una copia del estado actual y los registros relevantes. Comprueba la compatibilidad entre la versión que vas a recuperar y los datos que vas a mantener.
No desactives componentes al azar
Un módulo puede intervenir en precios, impuestos, transporte o sincronizaciones. Desactivarlo puede evitar que se ejecute la función que falla y, a la vez, dejar de realizar una operación necesaria.
Si desactivas varios componentes simultáneamente, tampoco sabrás cuál cambió el resultado. Y si el error desaparece porque la función ya no está disponible, aún no has recuperado esa función.
En su lugar: utiliza la traza y el contexto para elegir un candidato. Aísla una variable en un entorno de pruebas y comprueba tanto el error como el resultado funcional. Si la urgencia exige retirar temporalmente una función en producción, deja registrado qué se ha retirado y qué limitación tiene para el negocio.
No cambies todos los permisos a 777
Un error al abrir un archivo exige revisar la ruta, el propietario, el usuario del proceso y el acceso que necesita. Aplicar permisos 777 de forma recursiva concede acceso de lectura, escritura y ejecución a todos los usuarios del sistema sobre los elementos afectados, sin resolver necesariamente la condición que causó el fallo.
Además, una modificación masiva puede borrar las diferencias de permisos que existían entre archivos y directorios. Deshacerla correctamente requiere conocer el estado anterior.
En su lugar: localiza el elemento señalado y ajusta únicamente el acceso necesario para el proceso correspondiente. No presupongas que todos los archivos deben tener los mismos permisos ni que un error de acceso se resuelve siempre modificándolos.
No aumentes memoria y tiempos de espera sin saber qué los consume
Elevar un límite puede permitir que termine una operación legítima que lo supera por poco. Pero también puede prolongar un proceso atascado, permitir un consumo creciente o trasladar la presión al resto del servidor.
El hecho de que un cambio evite el error una vez no explica el consumo original ni garantiza que el sistema soporte varias operaciones simultáneas.
En su lugar: relaciona el límite alcanzado con la operación, el volumen de datos y el consumo observado. Si se decide ampliarlo como medida temporal, define qué valor se cambia, qué se vigilará y cuándo se revisará. Evita convertir una prueba en una configuración permanente sin evaluación.
No actualices todo a la vez para ver si se arregla
Actualizar el núcleo, las extensiones, el tema y PHP en una misma intervención introduce demasiadas diferencias para interpretar el resultado. Puede corregir el fallo inicial y añadir una incompatibilidad distinta.
Esto no significa posponer indefinidamente las actualizaciones. Significa distinguir el diagnóstico de una incidencia de una actualización general del entorno.
En su lugar: si una versión corrige un defecto que coincide con tu evidencia, prueba ese cambio con sus dependencias y requisitos. Documenta el resultado antes de añadir otra modificación.
No improvises cambios en producción sin una forma de volver atrás
Editar directamente un archivo activo puede introducir un error de sintaxis o dejar a los usuarios ejecutando una versión parcial. Tampoco basta con decir «luego lo deshacemos» si el cambio modifica datos o activa operaciones externas.
En su lugar: prepara el cambio y su reversión, conserva la versión anterior y define una comprobación breve de éxito. Si intervienen varias personas, acuerda quién ejecuta los cambios y registra cada uno: dos correcciones simultáneas pueden interferir incluso si ambas parecen razonables por separado.
No borres los registros ni dejes el debug expuesto
Eliminar los logs para empezar de cero puede hacer desaparecer la única evidencia de un fallo intermitente. Mostrar trazas en la web pública añade otro problema: rutas, consultas o datos de la operación podrían quedar visibles para visitantes.
En su lugar: conserva el intervalo relevante, marca la hora de cada prueba y utiliza registros privados con el detalle necesario. Al finalizar, retira la depuración temporal que ya no haga falta y protege los archivos generados.
Antes de ejecutar una acción, comprueba estas cuatro cosas
| Pregunta | Qué debería quedar claro |
|---|---|
| ¿Qué evidencia justifica el cambio? | La petición, el mensaje o la comparación que sostiene la hipótesis. |
| ¿Qué puede alterar además del error? | Funciones, datos, usuarios e integraciones que podrían verse afectados. |
| ¿Cómo vuelvo al estado anterior? | La copia o versión necesaria y los límites de esa reversión, especialmente si cambian datos. |
| ¿Cómo sabré si ha funcionado? | Una comprobación de la operación y su resultado, no solo de la desaparición del mensaje. |
Cuanto más concreta sea la intervención, más fácil será entender su efecto, revertirla si no funciona y conservar una explicación de lo ocurrido.
Cuando la web está vendiendo o prestando un servicio, estas decisiones deben convivir con la urgencia de recuperar la actividad. En la siguiente sección veremos cómo separar una mitigación temporal de la solución definitiva.
Cómo actuar cuando la web está vendiendo o prestando un servicio
Mientras investigas el error, puede haber clientes intentando pagar, personas enviando solicitudes o un equipo que no puede trabajar. En ese contexto, encontrar la causa y recuperar la actividad son tareas relacionadas, pero no siempre terminan al mismo tiempo.
La prioridad es recuperar una operación fiable sin perder el control de los datos ni de los cambios. A veces será posible corregir el defecto de inmediato. Otras veces convendrá limitar temporalmente una función mientras se investiga.
Delimita el impacto antes de decidir qué recuperar primero
No todas las incidencias requieren detener toda la web. Si falla una exportación administrativa, el proceso de compra podría seguir operativo. Si falla la validación de pedidos, mantener un checkout que invita a repetir el pago puede aumentar la confusión.
Identifica la función afectada, quién depende de ella y qué operaciones podrían haber quedado a medias. Con esa información, decide si existe una alternativa fiable o si conviene suspender temporalmente esa operación concreta.
Si se utiliza una alternativa manual, deja definido quién la gestiona y cómo se incorporarán después sus datos al sistema. Recibir solicitudes por otra vía solo ayuda si se pueden tramitar sin duplicarlas ni perderlas.
Mitigación y solución definitiva: dos resultados diferentes
| Resultado | Qué consigue | Qué queda pendiente |
|---|---|---|
| Mitigación | Reduce el impacto o permite continuar con una alternativa controlada. | Explicar y corregir el fallo, revisar limitaciones y retirar la medida temporal cuando proceda. |
| Solución verificada | Corrige el mecanismo identificado y supera las comprobaciones de la operación afectada. | Observar su comportamiento en condiciones representativas y conservar lo aprendido para prevenir recurrencias. |
Una reversión compatible, la retirada temporal de una función opcional o un procesamiento manual supervisado pueden ser mitigaciones. Su validez depende del caso: ninguna debe darse por adecuada sin revisar qué cambia para usuarios y datos.
Conserva las evidencias mínimas mientras recuperas el servicio
No hace falta terminar una investigación extensa antes de mitigar una interrupción grave. Sí conviene conservar lo que podría desaparecer al intervenir: hora y alcance del fallo, registros del intervalo, versión activa y cambio que se va a realizar.
Si el trabajo lo realizan varias personas, una puede recopilar esas evidencias mientras otra prepara la recuperación. Si lo hace una sola, prioriza una recogida breve y pertinente. Documenta cualquier información que no haya sido posible conservar.
La conservación de evidencias y la preparación de la recuperación pueden avanzar en paralelo. El alcance depende de la gravedad y de los medios disponibles.
Verifica una operación completa, no solo la portada
Después de intervenir, repite de forma controlada la acción que fallaba. Comprueba el resultado que necesita el usuario y su reflejo en los sistemas implicados.
| Operación afectada | Qué comprobar además de la respuesta web |
|---|---|
| Compra | Importe, pedido y estado del pago coherentes; stock y notificaciones según el funcionamiento previsto. |
| Formulario | Datos guardados y entrega o notificación al destino esperado, sin duplicados. |
| Sincronización | Actualización correcta en origen y destino, con tratamiento de operaciones pendientes. |
| Informe | Datos completos, filtros correctos y ausencia de omisiones o duplicaciones. |
Evita generar cobros o envíos reales innecesarios durante las pruebas. Utiliza los mecanismos de prueba disponibles o una operación acordada y trazable. Si no puedes verificar alguna parte, deja constancia de esa limitación antes de declarar la recuperación completa.
Revisa lo que pudo quedar a medias
La recuperación no procesa automáticamente todo lo que falló durante la incidencia. Puede haber pedidos sin actualizar, formularios guardados sin aviso, sincronizaciones pendientes o tareas interrumpidas.
Delimita el intervalo afectado y compara los estados de cada sistema. Antes de repetir una operación, comprueba si ya produjo algún efecto. Reenviar una tarea que terminó parcialmente puede duplicar una acción si no está preparada para reconocer repeticiones.
Esta reconciliación es distinta de la prueba de la corrección: una comprueba que las nuevas operaciones funcionan; la otra resuelve las consecuencias de las anteriores.
Comunica el estado y fija cuándo revisar la medida temporal
Un mensaje útil explica qué función está afectada, qué alternativa existe y cuándo habrá una nueva actualización. Evita anunciar que todo está resuelto si solo se ha recuperado parte del servicio.
Deja registrada la medida temporal, quién la revisará y qué condición permitirá retirarla. Si se elevó un límite o se desactivó una integración, esa decisión no debería quedar olvidada cuando desaparezca la urgencia.
Para confirmar la corrección, combina la prueba controlada con observación posterior en condiciones relevantes: la tarea programada que fallaba, el volumen de datos afectado o la franja de actividad correspondiente. Unos minutos sin errores con poca actividad no prueban el comportamiento bajo otras condiciones.
Debe quedar claro qué funciona, qué se ha corregido, qué operaciones se han reconciliado y qué limitaciones o comprobaciones siguen pendientes.
En la siguiente sección veremos qué puedes comprobar con los accesos que ya tienes y cuándo necesitas a alguien con acceso técnico al servidor.
Cuándo puedes resolverlo tú y cuándo necesitas acceso técnico al servidor
Para investigar un error 500 no siempre necesitas entrar por SSH. A veces, el panel del alojamiento ofrece el registro que falta o permite comprobar un cambio reciente. En otros casos, el administrador de la web sigue accesible, pero no muestra lo que ocurre en PHP o en el servidor.
La pregunta útil es qué necesitas comprobar y qué acceso permite hacerlo. Tener permiso para modificar algo tampoco implica que esa modificación esté justificada: primero debe existir una evidencia y una forma de verificar el resultado.
Desde el panel: recoge contexto y comprueba lo que esté documentado
Si puedes entrar al CMS, revisa las versiones, los componentes instalados y los cambios recientes que estén disponibles. Desde el panel del alojamiento quizá puedas consultar errores, configuración de PHP, copias o métricas; las funciones dependen del proveedor y del plan contratado.
Puedes avanzar por tu cuenta cuando entiendes la comprobación, su alcance y su resultado esperado. Por ejemplo, consultar un registro o identificar la versión activa no exige cambiar la aplicación.
Una modificación requiere más: saber qué afecta, conservar el estado previo y poder revertirla. Si el panel ofrece una acción como «restaurar» o «cambiar PHP», su facilidad de uso no elimina sus consecuencias sobre datos y compatibilidades.
Qué permite cada acceso y dónde están sus límites
| Acceso disponible | Para qué puede servir | Qué no garantiza |
|---|---|---|
| Administrador del CMS | Consultar componentes, configuración y registros que exponga la aplicación. | Ver errores previos al arranque del CMS o controlar el servidor. |
| Panel del alojamiento | Consultar logs, recursos, PHP y copias si el proveedor ofrece esas funciones. | Acceder a todos los procesos o comprender por sí solo el código que falla. |
| SFTP o gestor de archivos | Leer archivos y registros accesibles, conservar copias y revisar configuraciones autorizadas. | Inspeccionar procesos, ejecutar comandos o acceder a archivos fuera de sus permisos. |
| SSH | Consultar el entorno, procesos y registros permitidos; ejecutar herramientas de diagnóstico. | Tener privilegios administrativos ni autorización para reiniciar o cambiar cualquier servicio. |
| Acceso a base de datos | Comprobar estructuras y estados relacionados con la operación, con los permisos adecuados. | Que modificar registros sea necesario o seguro para resolver la incidencia. |
El acceso SFTP permite transferir archivos mediante una conexión cifrada. No debe confundirse con disponer de una consola SSH, aunque ambos puedan utilizar credenciales o infraestructura relacionadas. Si solo necesitas que alguien lea un registro, evita conceder acceso de escritura a toda la aplicación.
Cuándo conviene implicar al proveedor del alojamiento
Recurre al proveedor cuando la comprobación depende de información que no tienes disponible: registros privados del servidor, límites efectivos del entorno, procesos detenidos o cambios realizados por el propio alojamiento.
Facilita una petición concreta. «La web falla» obliga a empezar de cero; «esta URL devuelve 500 desde esta hora y necesito el registro de PHP asociado» permite centrar la revisión.
El soporte puede confirmar que el entorno funciona y señalar una excepción de la aplicación. Eso no resuelve necesariamente el defecto de código. A la inversa, una aplicación que falla al conectarse a otro servicio puede necesitar una comprobación de infraestructura. La evidencia debe guiar quién interviene después.
Cuándo necesitas desarrollo o administración de sistemas
Si la investigación exige interpretar una traza, revisar una personalización, corregir una integración o verificar una migración de datos, hace falta conocimiento de la aplicación. Si exige estudiar procesos, permisos efectivos, configuración del servidor web o recursos compartidos, entra en juego la administración de sistemas.
En algunas incidencias participan ambos perfiles. La clave es compartir una misma petición, sus registros y los cambios realizados, para evitar que cada uno investigue un caso distinto o intervenga simultáneamente sin coordinación.
Si el fallo se sitúa en el entorno de ejecución o en la infraestructura, nuestro servicio de administración de sistemas y servidores aborda esas comprobaciones. Cuando la evidencia apunta a WordPress o PrestaShop, las secciones anteriores enlazan con los servicios específicos de cada aplicación.
Qué enviar para que la ayuda empiece por el diagnóstico
No necesitas explicar la causa si todavía no la conoces. Envía hechos observados y separa las sospechas de las comprobaciones. Puedes utilizar esta ficha:
Si se necesitan credenciales, compártelas por un canal privado adecuado y limita sus permisos al trabajo previsto. Cuando sea posible, utiliza una cuenta temporal identificable y retira el acceso al finalizar la intervención.
«Necesitamos relacionar esta petición con el error de PHP» orienta el trabajo. «Subid la memoria porque hay un 500» propone un cambio antes de demostrar que sea necesario.
Con el alcance y los accesos claros, podemos reunir el proceso en una checklist reutilizable. Será el siguiente bloque de esta guía.
Checklist de diagnóstico de un error 500
Esta checklist reúne el recorrido de la guía para utilizarlo durante una incidencia. Marca un paso cuando tengas la información o hayas realizado la comprobación; si no puedes completarlo, anota qué falta y quién puede facilitarlo.
Las casillas sirven de apoyo a la lectura y se reinician al recargar la página. Guarda las evidencias y las decisiones en tu propio registro de la incidencia.
1. Delimita el fallo
Apoyo: reconstruir lo ocurrido antes del fallo.
2. Conserva y relaciona las evidencias
Apoyo: localizar la capa y interpretar los logs.
3. Prepara una prueba controlada
Apoyo: elegir la ruta de diagnóstico y evitar cambios que agraven el fallo.
4. Verifica la recuperación
Si un paso no se puede completar, deja visible el límite
No hace falta marcar todas las casillas para reducir el impacto de una interrupción grave. La recuperación y la conservación de evidencias pueden avanzar en paralelo. Pero una comprobación pendiente debe seguir figurando como pendiente: no se convierte en un resultado correcto por falta de acceso o de tiempo.
| Situación | Siguiente paso útil |
|---|---|
| No tengo acceso al registro que necesito. | Solicitar el intervalo y la petición concretos al proveedor o responsable técnico. |
| La prueba no produce el resultado esperado. | Revisar la hipótesis y las diferencias del entorno antes de añadir otro cambio. |
| El error desapareció, pero no sé por qué. | Registrar la recuperación y mantener la causa como no confirmada. |
| La función vuelve a responder, pero hay datos pendientes. | Separar la recuperación del servicio de la reconciliación de esas operaciones. |
Si necesitas trasladar el caso a otra persona, utiliza la ficha de solicitud de ayuda y añade el último paso completado. Así podrá continuar desde una evidencia concreta.
La siguiente sección responderá a las dudas habituales que pueden quedar después del diagnóstico: errores intermitentes, implicaciones para SEO y posibles relaciones con el hosting o servicios externos.
Preguntas frecuentes sobre el error 500
¿Un error 500 significa que la web está hackeada?
No. El código indica un fallo interno al atender una petición, pero no identifica su causa. Un defecto de código, una configuración incompatible o una dependencia fallida pueden producirlo sin que exista una intrusión.
Si además observas archivos modificados sin explicación, accesos desconocidos o redirecciones inesperadas, conserva esas evidencias y amplía la investigación. Son indicios que deben revisarse por sí mismos; el 500 no confirma ni descarta un incidente de seguridad.
¿Puede desaparecer solo un error 500?
Sí, puede dejar de manifestarse si cambian las condiciones que lo provocaban: una dependencia vuelve a responder, termina una tarea que interfería o la siguiente petición llega a otra instancia.
Eso confirma que una nueva petición ha funcionado, no que el defecto esté corregido. Conserva las horas y registros de los fallos y compara sus condiciones con las operaciones correctas. La checklist de diagnóstico ayuda a dejar visibles las comprobaciones pendientes.
¿Puede provocarlo el hosting?
Sí. La configuración del alojamiento, los recursos disponibles o un problema en el entorno de ejecución pueden intervenir. También puede generarlo el código de la web alojada allí.
Para distinguirlos, solicita el registro asociado a la petición y comprueba dónde se interrumpió el recorrido. Que el mensaje incluya la palabra «servidor» o el logotipo del proveedor no basta para atribuirle la causa.
¿Un error 500 afecta al SEO?
Puede hacerlo si afecta a las URLs que Google intenta rastrear. Google explica que los errores 5xx reducen temporalmente el ritmo de rastreo y que las URLs que devuelven errores de servidor de forma persistente pueden acabar saliendo del índice. El contenido recibido con un estado 5xx se ignora. Puedes consultar la documentación de Google sobre errores de servidor.
Esto no significa que un fallo aislado provoque una pérdida inmediata de posiciones. Revisa qué URLs están afectadas, su persistencia y los informes de Search Console, además de los registros. Un error en una acción privada del administrador no tiene el mismo alcance para el rastreo que un error en todas las fichas públicas del catálogo.
La prioridad es recuperar la respuesta y el contenido correctos. Devolver un 200 con una pantalla vacía o un mensaje de error no repara la página ni garantiza su indexación.
¿Por qué el error 500 aparece solo algunas veces?
Porque las peticiones no siempre se ejecutan en las mismas condiciones. Pueden cambiar los datos, la sesión, la carga, la instancia que atiende la petición o la respuesta de un servicio externo.
Compara un caso fallido con uno correcto y conserva sus identificadores cuando existan. No reduzcas la investigación a «falta de potencia» sin comprobar qué coincide con los fallos. La sección de diagnóstico según cuándo aparece propone rutas para acotar esas diferencias.
¿Por qué falla el administrador, pero la web pública funciona?
El administrador puede ejecutar código y operaciones que la parte pública no utiliza: guardar datos, generar informes o cargar herramientas de gestión. Además, una página pública puede servirse desde caché sin recorrer todos los componentes que necesita una operación administrativa.
Identifica la pantalla y la acción concretas que fallan. Que la portada abra no demuestra que todas las funciones del CMS o todas sus conexiones estén operativas.
¿Puede una API externa causar un error 500 en mi web?
Sí, si la aplicación no gestiona adecuadamente una respuesta inesperada o un fallo de comunicación con esa API. El estado que recibe el visitante puede ser distinto del que devolvió el proveedor.
Relaciona la llamada externa, su respuesta y el fallo local. La corrección puede requerir actuar sobre la integración, sus credenciales o su tratamiento de errores; no siempre consiste en esperar a que el proveedor cambie algo.
¿Debo recargar la página hasta que funcione?
Una comprobación puntual de lectura puede ayudar a saber si el fallo continúa. Repetir insistentemente la petición aporta poca información y puede añadir carga.
Si estabas pagando, enviando un formulario o ejecutando una operación que modifica datos, comprueba primero su estado. La operación pudo completarse parcialmente aunque la respuesta terminara en error. Evita reenviarla sin saber si puede duplicar un cobro, un envío o un registro.
¿Cómo sé que el error está realmente solucionado?
Debes poder repetir la operación afectada en condiciones relevantes, obtener el resultado correcto y comprobar que no reaparece el fallo asociado. Revisa también los datos y tareas que pudieron quedar pendientes durante la incidencia.
Si solo has retirado temporalmente una función o aplicado una alternativa, registra el estado como mitigado. La sección sobre recuperación del servicio explica cómo separar ambos resultados.
Guarda cuándo falló, qué estabas haciendo y qué registró el sistema. Esos tres datos convierten una pantalla genérica en un problema que se puede investigar y verificar.
Conclusiones: del error 500 a una intervención concreta
Un error 500 indica que una petición no ha podido completarse con normalidad. Para resolverlo, necesitas pasar del mensaje genérico a una explicación comprobable: qué operación falla, en qué condiciones, qué registró el sistema y qué componente interviene.
Con esas evidencias puedes preparar una corrección proporcionada, verificar el resultado y revisar las operaciones que hayan quedado pendientes. Si has aplicado una mitigación, deja identificado qué falta para considerar resuelta la incidencia.
Si necesitas que dev2bit se encargue del diagnóstico y la intervención, podemos estudiar el caso y concretar el trabajo necesario. El servicio adecuado depende de dónde esté el fallo y de lo que necesites recuperar.
Resolver un fallo en WordPress
Para incidencias relacionadas con temas, plugins, código propio o integraciones. Revisamos el recorrido afectado y definimos la corrección y sus pruebas.
Recuperar una función de tu PrestaShop
Para errores en módulos, catálogo, carrito, checkout o Back Office. La intervención contempla el comportamiento de la tienda y los datos de la operación.
Revisar el servidor y su configuración
Cuando el diagnóstico requiere analizar PHP, procesos, permisos, recursos o la comunicación entre componentes del alojamiento.
Corregir una integración entre sistemas
Para fallos al intercambiar datos con una API, ERP u otro servicio. Revisamos la conexión y el tratamiento de respuestas, errores y operaciones pendientes.
Delegar el mantenimiento de tu web
Para dar continuidad a las actualizaciones, comprobaciones y gestión de incidencias, con tareas, responsables y cobertura acordados.